这是「Docker 好项目」系列的第 14 期。第 5 期讲了 Stirling-PDF,那是「临时处理一份 PDF」的工具;这一期解决另一件更长期的事:把手里的纸质票据、合同、保单、说明书变成一座能按内容搜索的档案库。
痛点开场
先说一个几乎人人中招的场景。
一张三年前的车辆保险单,客户要用;一份半年前的维修结算单,财务要对账;一台家电的维修记录、一份上牌用的合格证照片——你确定它在手机里的某个相册里,但你不确定是哪个。于是你打开相册往上翻,翻到手指发酸。
云盘能解决"存"的问题,解决不了"找"的问题:它只能按文件名和文件夹找。而现实是——扫描出来的单据根本没有文件名,全是 IMG_20260912_0013.jpg 这种。你当初存的时候记得清清楚楚,三个月后连自己存过都忘了。
Paperless-ngx 解决的就是这一步:文件扔进"收件箱",它做 OCR、抽日期、抽金额、猜测是谁开给你的、按规则打标签、按你定义的路径重命名归档,然后把全文索引建起来。之后你只记得单据上有个词——比如"交强险""保养""年检"——搜这个词,那页纸就出来了。
它跟我自己那套工作流的关系是这样:星耀(我的飞牛 NAS)上跑着 Immich 管照片、Navidrome 管音乐,这台华为云 ECS 上跑着博客和 1Panel。照片是给人看的,文档是给人查的——这两件事的索引逻辑完全不同,所以它们值得各占一个服务。
能力边界
能干什么
- 消费目录(consume)自动导入:任何丢进
consume/的文件都会被吃进去,支持 PDF、图片(jpg/png/tiff/…)和纯文本;Office 文档(Word/Excel/PPT)需要额外的 Tika + Gotenberg 容器 - OCR 全文检索:基于 OCRmyPDF + Tesseract,加文字层之后连扫描件也能搜;v3 起搜索引擎换成 Tantivy(原来 Whoosh)
- 元数据自动识别:日期、通讯录(correspondent,一般就是开票方)、文档类型、金额、标签;还有可训练的分类器,你标记几次之后它会自己学
- 自定义字段:给单据加"合同编号""车牌号""金额"这类结构化字段,然后按字段筛选
- 工作流(Workflow):新文件进来时按条件触发动作——打标签、设权限、改标题、发 Webhook。这一条是跟第 13 期 ntfy 对接的关键
- 邮件收取:配好 IMAP 之后,它自己去邮箱里把带附件的邮件捞出来导入(发票自动归档的经典玩法)
- 条码/ASN 分割:扫描时插入分隔页,一份 PDF 自动拆成多份;条码还能当标签注入(v3 起只剩 zxing-cpp 引擎)
- 全文检索 + 保存视图:搜索语法、保存筛选条件、批量编辑
- 多用户 + 细粒度权限:文档级、全局级权限;分享链接(可设过期)
- 文件版本:v3 新增,同一份文档可以保留历史版本
- AI 辅助建议(可选):接 OpenAI 兼容端点,让它帮你猜标题/标签,默认关闭
不干什么
- 不扫描。它不会驱动你的扫描仪。要么用扫描仪自带软件扫完丢进
consume/,要么用手机扫描类 App 导出 PDF 再传上去 - 不做同步盘。它管理的是"档案",不是你正在编辑的文件。想要双向同步请找 Syncthing / Nextcloud
- 不修改原始文件。原始 PDF 它只读不改(OCR 结果是另存成 PDF/A 归档副本),想编辑 PDF 请回第 5 期 Stirling-PDF
- 不替代记账/报销系统。它能存发票、能全文搜,但不会帮你出利润表
- 不开箱即用。它是本篇里配置项最多的一期——但好消息是默认值基本够用,你要动的就那几个
一句话:Paperless-ngx 是你的文件柜,不是你的书桌。
部署前准备
- 一台能跑 Docker 的机器。官方最低要求不高,2 核 2G 能跑;但OCR 是纯 CPU 活,扫一份多页 PDF 能吃满一个核几十秒。华为云 ECS 上跟 1Panel 并排跑没问题,只要别同时压榨 CPU
- 规划域名,比如
docs.你的域名.com。这期强烈建议配域名 + HTTPS——它的分享链接、邮件里的链接、CSRF 校验全都依赖一个正确的对外地址 - 华为云安全组放行 80/443(给反向代理用)。8000 端口不要对公网开,映射成
127.0.0.1:8000由反代转发 - 想清楚存储放哪。它有两块数据:数据库(元数据)+
media/里的原件。原件会长期增长,建议挂到大盘或 NAS 上,别跟系统盘挤 - 镜像。官方主推
ghcr.io/paperless-ngx/paperless-ngx,Docker Hub 上同一个项目叫paperlessngx/paperless-ngx。
关于镜像 tag,这期我实测了一遍(v3.2.1 发布后):
| tag | 结果 |
|---|---|
3 |
404,不存在 |
3.2 |
200 |
3.2.1 |
200 |
latest |
200 |
3.2、3.2.1、latest 三个 tag 的 manifest digest 完全相同(sha256:5fa76604a81d…),而且我在 ghcr.io 和 Docker Hub 两边都测了,digest 一致。再往上验历史:3.1 与 3.1.3 digest 相同、3.0 与 3.0.5 也相同——说明它的次版本 tag 确实会随补丁滚动(跟第 10 期 Gitea、第 13 期 ntfy 同类)。
所以这期推荐 :3.2:能吃到 3.2.x 的补丁,又不会被 3.3 的破坏性变更偷袭。别用 :latest——这个项目半年发了一大堆 minor 版本,latest 指向哪一期纯看运气。
⚠️ 如果你是从 v2 升级来的,v3 有不少破坏性变更(包括 PAPERLESS_SECRET_KEY 变成必填、数据库引擎必须显式写、OCR_MODE=skip 被移除等)。官方要求只能从 v2.20.15 升到 v3,细节我放在后面的踩坑清单里。
docker run 一行版
严格说这期没法"一行"——Paperless-ngx 必须有一个 Redis 兼容的 broker(celery 排任务用),所以最少是"两个容器"。下面这套用 SQLite 当数据库,适合先跑通看效果:
# 1) 建网络 + broker(官方 compose 现在用 valkey 代替 redis)
docker network create paperless

docker run -d \
  --name paperless-redis \
  --network paperless \
  --restart unless-stopped \
  valkey/valkey:9-alpine

# 2) 建目录
mkdir -p /opt/paperless/{data,media,consume,export}

# 3) 起 Paperless-ngx
docker run -d \
  --name paperless \
  --network paperless \
  -p 127.0.0.1:8000:8000 \
  -v /opt/paperless/data:/usr/src/paperless/data \
  -v /opt/paperless/media:/usr/src/paperless/media \
  -v /opt/paperless/consume:/usr/src/paperless/consume \
  -v /opt/paperless/export:/usr/src/paperless/export \
  -e PAPERLESS_REDIS=redis://paperless-redis:6379 \
  -e PAPERLESS_SECRET_KEY="$(openssl rand -base64 48)" \
  -e PAPERLESS_URL=https://docs.你的域名.com \
  -e PAPERLESS_TIME_ZONE=Asia/Shanghai \
  -e PAPERLESS_OCR_LANGUAGE=chi_sim \
  -e PAPERLESS_OCR_LANGUAGES=chi-sim \
  -e USERMAP_UID=1000 \
  -e USERMAP_GID=1000 \
  --restart unless-stopped \
  ghcr.io/paperless-ngx/paperless-ngx:3.2
几个必须知道的点:
PAPERLESS_SECRET_KEY是硬性要求。v3 起不设、或者还留着示例值change-me,容器会直接抛ImproperlyConfigured起不来(源码settings/__init__.py里写的)。上面用openssl rand -base64 48现场生成一个就行,注意把它记下来、别每次重启都换新的——它一换,所有登录会话和签名令牌全部失效。PAPERLESS_URL不做校验但极其重要。源码里它会被同时塞进ALLOWED_HOSTS、CSRF_TRUSTED_ORIGINS、CORS_ALLOWED_ORIGINS。写错的话表现是"能打开、但一登录就 CSRF 报错",或者分享链接指向 localhost。不要带结尾斜杠。- 两行"中文 OCR"必须配对写,这是国内用户最容易翻车的地方:
PAPERLESS_OCR_LANGUAGES=chi-sim→ 装的是 Debian 包tesseract-ocr-chi-sim(连字符)PAPERLESS_OCR_LANGUAGE=chi_sim→ OCR 时用的语言代码(下划线)- 写反了不会报错,只会 OCR 出满屏乱码,或者启动日志里一行
Skipped tesseract-ocr-chi_sim: Package not found! - 额外语言包是容器启动时用 apt 现场装的——所以第一次启动要联网、要花几十秒。也正因为要 apt,它不能以非 root 用户运行(官方文档原文:"It is not possible to run the container rootless if additional languages are specified via
PAPERLESS_OCR_LANGUAGES")。要中文 OCR,就别给容器加user:。 - 这里映射成
127.0.0.1:8000,是留给后面的反向代理——别把 8000 直接开到公网,这是个存着全部档案的系统。
docker-compose 推荐版
正式环境用这份(基于官方 docker/compose/docker-compose.postgres-tika.yml 改的,改动了三处:钉版本、加固配置、加中文 OCR):
services:
  broker:
    image: docker.io/valkey/valkey:9-alpine
    container_name: paperless-broker
    restart: unless-stopped
    volumes:
      - redisdata:/data

  db:
    image: docker.io/library/postgres:18
    container_name: paperless-db
    restart: unless-stopped
    volumes:
      # ⚠️ postgres:18 起数据目录改成 /var/lib/postgresql(PGDATA=/var/lib/postgresql/18/docker)
      #    老教程里的 /var/lib/postgresql/data 是 17 及以前的路径,照着抄会白挂一个空卷
      - pgdata:/var/lib/postgresql
    environment:
      POSTGRES_DB: paperless
      POSTGRES_USER: paperless
      POSTGRES_PASSWORD: 换成你自己的强密码

  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:3.2
    container_name: paperless
    restart: unless-stopped
    depends_on:
      - db
      - broker
      - gotenberg
      - tika
    ports:
      - "127.0.0.1:8000:8000"      # 只绑本机,由反向代理对外
    volumes:
      - ./data:/usr/src/paperless/data       # 数据库配置、索引、日志
      - ./media:/usr/src/paperless/media     # 原始文件 + 归档副本 + 缩略图(会越来越大)
      - ./consume:/usr/src/paperless/consume # 收件箱:往里丢文件
      - ./export:/usr/src/paperless/export   # 导出目录
    env_file: docker-compose.env
    environment:
      PAPERLESS_REDIS: redis://broker:6379
      PAPERLESS_DBENGINE: postgresql     # v3 起必须显式写,不能再靠 DBHOST 推断
      PAPERLESS_DBHOST: db
      PAPERLESS_DBNAME: paperless
      PAPERLESS_DBUSER: paperless
      PAPERLESS_DBPASS: 换成你自己的强密码
      PAPERLESS_TIKA_ENABLED: 1
      PAPERLESS_TIKA_GOTENBERG_ENDPOINT: http://gotenberg:3000
      PAPERLESS_TIKA_ENDPOINT: http://tika:9998

  # 下面两个只在需要导入 Word/Excel/PPT 时才要,纯 PDF + 图片场景可以整段删掉,省 500M 内存
  gotenberg:
    image: docker.io/gotenberg/gotenberg:8.37
    container_name: paperless-gotenberg
    restart: unless-stopped
    command:
      - "gotenberg"
      # 转 .eml 时禁用 JS、限制只能读 /tmp,避免跟踪像素和脚本
      - "--chromium-disable-javascript=true"
      - "--chromium-allow-list=file:///tmp/.*"

  tika:
    image: docker.io/apache/tika:3.3.1.0
    container_name: paperless-tika
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
配套的 docker-compose.env:
# 必填:v3 起不设就起不来。生成:python3 -c "import secrets; print(secrets.token_urlsafe(64))"
PAPERLESS_SECRET_KEY=换成你生成的64位随机串

# 对外地址(不带结尾斜杠),反代、分享链接、CSRF 全靠它
PAPERLESS_URL=https://docs.你的域名.com

# 时区,否则界面上的日期会按 UTC 算,看着像差了 8 小时
PAPERLESS_TIME_ZONE=Asia/Shanghai

# 中文 OCR:包名用连字符,语言代码用下划线,两个都要
PAPERLESS_OCR_LANGUAGES=chi-sim
PAPERLESS_OCR_LANGUAGE=chi_sim

# 让容器里的 paperless 用户对上宿主机的 UID/GID,避免 consume 目录没权限
USERMAP_UID=1000
USERMAP_GID=1000

# 首次启动自动建管理员(三个都写上才会建)
PAPERLESS_ADMIN_USER=admin
PAPERLESS_ADMIN_MAIL=你的邮箱@example.com
PAPERLESS_ADMIN_PASSWORD=换成强密码
几个「为什么这么写」:
PAPERLESS_DBENGINE不能省。这是 v3 的破坏性变更:以前有PAPERLESS_DBHOST就自动认 Postgres,现在必须显式声明,否则它会安静地回落到 SQLite——你以为数据在 Postgres 里,其实在一个文件里。PAPERLESS_URL一旦填了,就不要再单独配ALLOWED_HOSTS/CSRF_TRUSTED_ORIGINS。源码里它是"顺带把这三个都设上"的写法,填两处只会让排查变麻烦。USERMAP_UID/GID:容器内默认用户是 uid 1000 的paperless。宿主机上你的用户如果也是 1000,就不用手动chown挂载目录。注意这两个变量在非 root 启动时无效(v3 的启动脚本会打一行警告),跟前面说的"中文 OCR 别用 rootless"是同一个约束。- 健康检查镜像里自带:
HEALTHCHECK --interval=30s CMD curl -fs -L http://localhost:8000,不用自己写。1Panel 的容器页能直接看到健康状态。 postgres:18的卷路径别抄老教程。这个镜像从 18 开始把VOLUME从/var/lib/postgresql/data改成了/var/lib/postgresql(PGDATA变成/var/lib/postgresql/18/docker)。照着旧文章写成/data子路径,后果是数据没落盘、重启即失忆。
配置项逐项解释
下面的默认值全部来自 v3.2.1 源码 src/paperless/settings/__init__.py 实测:
| 变量 | 默认值 | 说明 / 为什么这么写 |
|---|---|---|
PAPERLESS_SECRET_KEY |
无(必填) | 会话与签名令牌的密钥。v3 起留空或等于 change-me 直接启动失败 |
PAPERLESS_URL |
空 | 对外地址。填了会同时写入 ALLOWED_HOSTS、CSRF_TRUSTED_ORIGINS、CORS_ALLOWED_ORIGINS,别配 trailing slash |
PAPERLESS_ALLOWED_HOSTS |
* |
默认全放。设成具体值时会自动加 localhost(健康检查要用) |
PAPERLESS_TIME_ZONE |
UTC |
改成 Asia/Shanghai。文档日期识别依赖它 |
PAPERLESS_DBENGINE |
空(SQLite) | 用 Postgres/MariaDB 时必填 |
PAPERLESS_REDIS |
空 | broker 地址。用官方 compose 时填 redis://broker:6379 |
PAPERLESS_TASK_WORKERS |
1 |
celery 并发进程数。2C 机器保持 1;OCR 是 CPU 瓶颈,开多了只会互相抢 |
PAPERLESS_THREADS_PER_WORKER |
CPU核数 ÷ workers | 默认已经是自动分配的合理值,别乱动 |
PAPERLESS_WORKER_TIMEOUT |
1800 |
单个任务最长 30 分钟。超厚扫描件才需要调大 |
USERMAP_UID / USERMAP_GID |
容器内 1000 |
让容器用户对应宿主机 UID,免掉 chown。非 root 启动时无效 |
PAPERLESS_ADMIN_USER |
空(不自动建) | 配合下面两个变量,首次启动自动建超管 |
PAPERLESS_ADMIN_MAIL |
root@localhost |
超管邮箱,建议改成真实邮箱 |
PAPERLESS_ADMIN_PASSWORD |
空 | 不设就不会建用户,只会在日志里提示 |
PAPERLESS_OCR_LANGUAGE |
eng |
OCR 语言代码。中文简体 = chi_sim(下划线),多语言用 eng+chi_sim |
PAPERLESS_OCR_LANGUAGES |
空(不装) | 额外安装的语言包,用 Debian 包名的后缀。简体 = chi-sim(连字符)。镜像自带 eng/deu/fra/ita/spa |
PAPERLESS_OCR_MODE |
auto |
auto=已有文字层就跳过,force=强制重跑,off=完全不做 OCR。⚠️ 老的 skip / skip_noarchive 已被移除 |
PAPERLESS_ARCHIVE_FILE_GENERATION |
auto |
是否产出 PDF/A 归档副本,与 OCR 开关在 v3 已解耦。想恢复 v2 的"永远生成归档"就设 always |
PAPERLESS_OCR_PAGES |
不限 | 只 OCR 前 N 页。资料太多想省 CPU 时可以设 |
PAPERLESS_OCR_DESKEW |
true |
自动纠偏。扫描歪了的单据靠它救回来 |
PAPERLESS_CONSUMER_POLLING_INTERVAL |
0 |
0 = 用文件系统事件(即时)。放在 NFS/SMB 网络盘上必须改成正数(秒),否则它看不到新文件 |
PAPERLESS_CONSUMER_STABILITY_DELAY |
5 |
文件大小/时间连续 5 秒不变才开吃。网络盘慢或扫描仪写入慢时调大 |
PAPERLESS_CONSUMER_RECURSIVE |
false |
要不要递归扫子目录。按月份建文件夹的话就设 true |
PAPERLESS_CONSUMER_IGNORE_PATTERNS |
[] |
忽略规则。v3 起是正则(以前是 fnmatch),而且用户规则是追加到默认规则上,不是替换 |
PAPERLESS_CONSUMER_DELETE_DUPLICATES |
false |
v3 起默认不拒绝重复文件,改为在界面上提示。想恢复"重复就拒收"设 true |
PAPERLESS_FILENAME_FORMAT |
空 | 归档后的文件命名模板,例如 {{ created_year }}/{{ correspondent }}/{{ title }}。空 = 用内部 ID 命名 |
PAPERLESS_FILENAME_FORMAT_REMOVE_NONE |
false |
模板里解析不出来的变量直接省掉(不产生 none 目录名)。建议设 true |
PAPERLESS_EMAIL_HOST / _PORT |
localhost / 25 |
只影响发邮件(任务失败通知等),不影响收邮件 |
PAPERLESS_EMAIL_TASK_CRON |
*/10 * * * * |
收邮件频率。没显式设置时它会按 SECRET_KEY 的哈希把自己的分钟错开,避免所有实例同一时刻打 mail server;disable 可关 |
PAPERLESS_TRAIN_TASK_CRON |
5 */1 * * * |
训练分类器。老 CPU(缺 SSE4.2)上要设 disable,否则 worker 会 SIGILL 崩 |
PAPERLESS_INDEX_TASK_CRON |
0 0 * * * |
每天 0 点优化索引 |
PAPERLESS_SANITY_TASK_CRON |
30 0 * * sun |
每周日 0:30 一致性自检 |
PAPERLESS_EMPTY_TRASH_TASK_CRON |
0 1 * * * |
每天 1 点清空废纸篓。注意:删掉的文件过了这个点就真没了 |
PAPERLESS_WEBHOOKS_ALLOW_INTERNAL_REQUESTS |
true |
默认允许 Webhook 打内网地址。锁死就设 false |
PAPERLESS_TRUSTED_PROXIES |
空 | 反代后的真实 IP 识别。配合 fail2ban 防爆破时建议设 |
PAPERLESS_WEBSERVER_WORKERS |
1 |
Web 进程数,每个进程单独吃一份内存。2G 内存保持 1 |
PAPERLESS_AI_ENABLED |
NO |
AI 辅助建议,默认关闭,开了还要配 LLM 端点 |
PAPERLESS_POST_CONSUME_SCRIPT |
空 | 导入成功后触发的脚本。v3 起不再传位置参数 $1..$8,改用 DOCUMENT_ID 等环境变量 |
1Panel 面板怎么搞
先说结论:1Panel 应用商店里没有 Paperless-ngx。我把 1Panel-dev/appstore 的 264 个应用翻了一遍,paperless 相关的命中是 0(这不奇怪,它需要 4~5 个容器协同,不适合做成"填两个参数就装好"的模板)。
所以在这台华为云 ECS 上,正确姿势是走 容器 → 编排(Compose):
- 1Panel 左侧 容器 → 编排 → 创建编排
- 名称填
paperless,把上面那份docker-compose.yml和docker-compose.env贴进去 - 1Panel 会把项目目录放在它自己的应用目录下(一般是
/opt/1panel/docker/compose/paperless),四个数据目录data/ media/ consume/ export/都会生成在里面 - 点部署,等它把 5 个镜像拉下来——这一步在国内可能很慢,因为主镜像在 ghcr.io。拉不动的话在 1Panel 的 容器 → 配置 → 镜像加速 里配一个加速地址,或者临时把镜像换成 Docker Hub 的
paperlessngx/paperless-ngx:3.2(我实测两个 registry 的 digest 完全相同,是同一份东西) - 起来之后在 1Panel 的 容器 页能看到
paperless是 healthy
两个 1Panel 实操提示:
- 别在 1Panel 里手改容器的端口映射。改了之后
PAPERLESS_URL和实际的入口不一致,CSRF 会跟你翻脸。要改就改编排文件再重新部署。 - 反向代理用 1Panel 的"网站"功能建:新建网站 → 反向代理 → 目标填
http://127.0.0.1:8000→ 申请 Let's Encrypt 证书。上传大 PDF 时记得把 Nginx 的client_max_body_size提到100m以上,否则几十兆的扫描件会 413。
首次访问
- 先确认容器活着、健康检查通过:
curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8000
# 200(或 302 到登录页,两个都算正常)
- 浏览器打开
https://docs.你的域名.com - 第一次访问它会直接引导你创建超级管理员账号(官方文档原话:you will be prompted to create a superuser account)。如果你在前面
.env里写了PAPERLESS_ADMIN_*三个变量,那账号已经自动建好了,直接登录 - 登录后先去 Documents → 界面上传一份 PDF 试试,看能不能正常 OCR、能不能搜到里面的词
- 再验证收件箱:
# 往消费目录丢一份文件,等几秒
cp 某张单据.pdf /opt/1panel/docker/compose/paperless/consume/
# 看日志确认它在吃
docker logs -f paperless 2>&1 | grep -i "consume\|ocr"
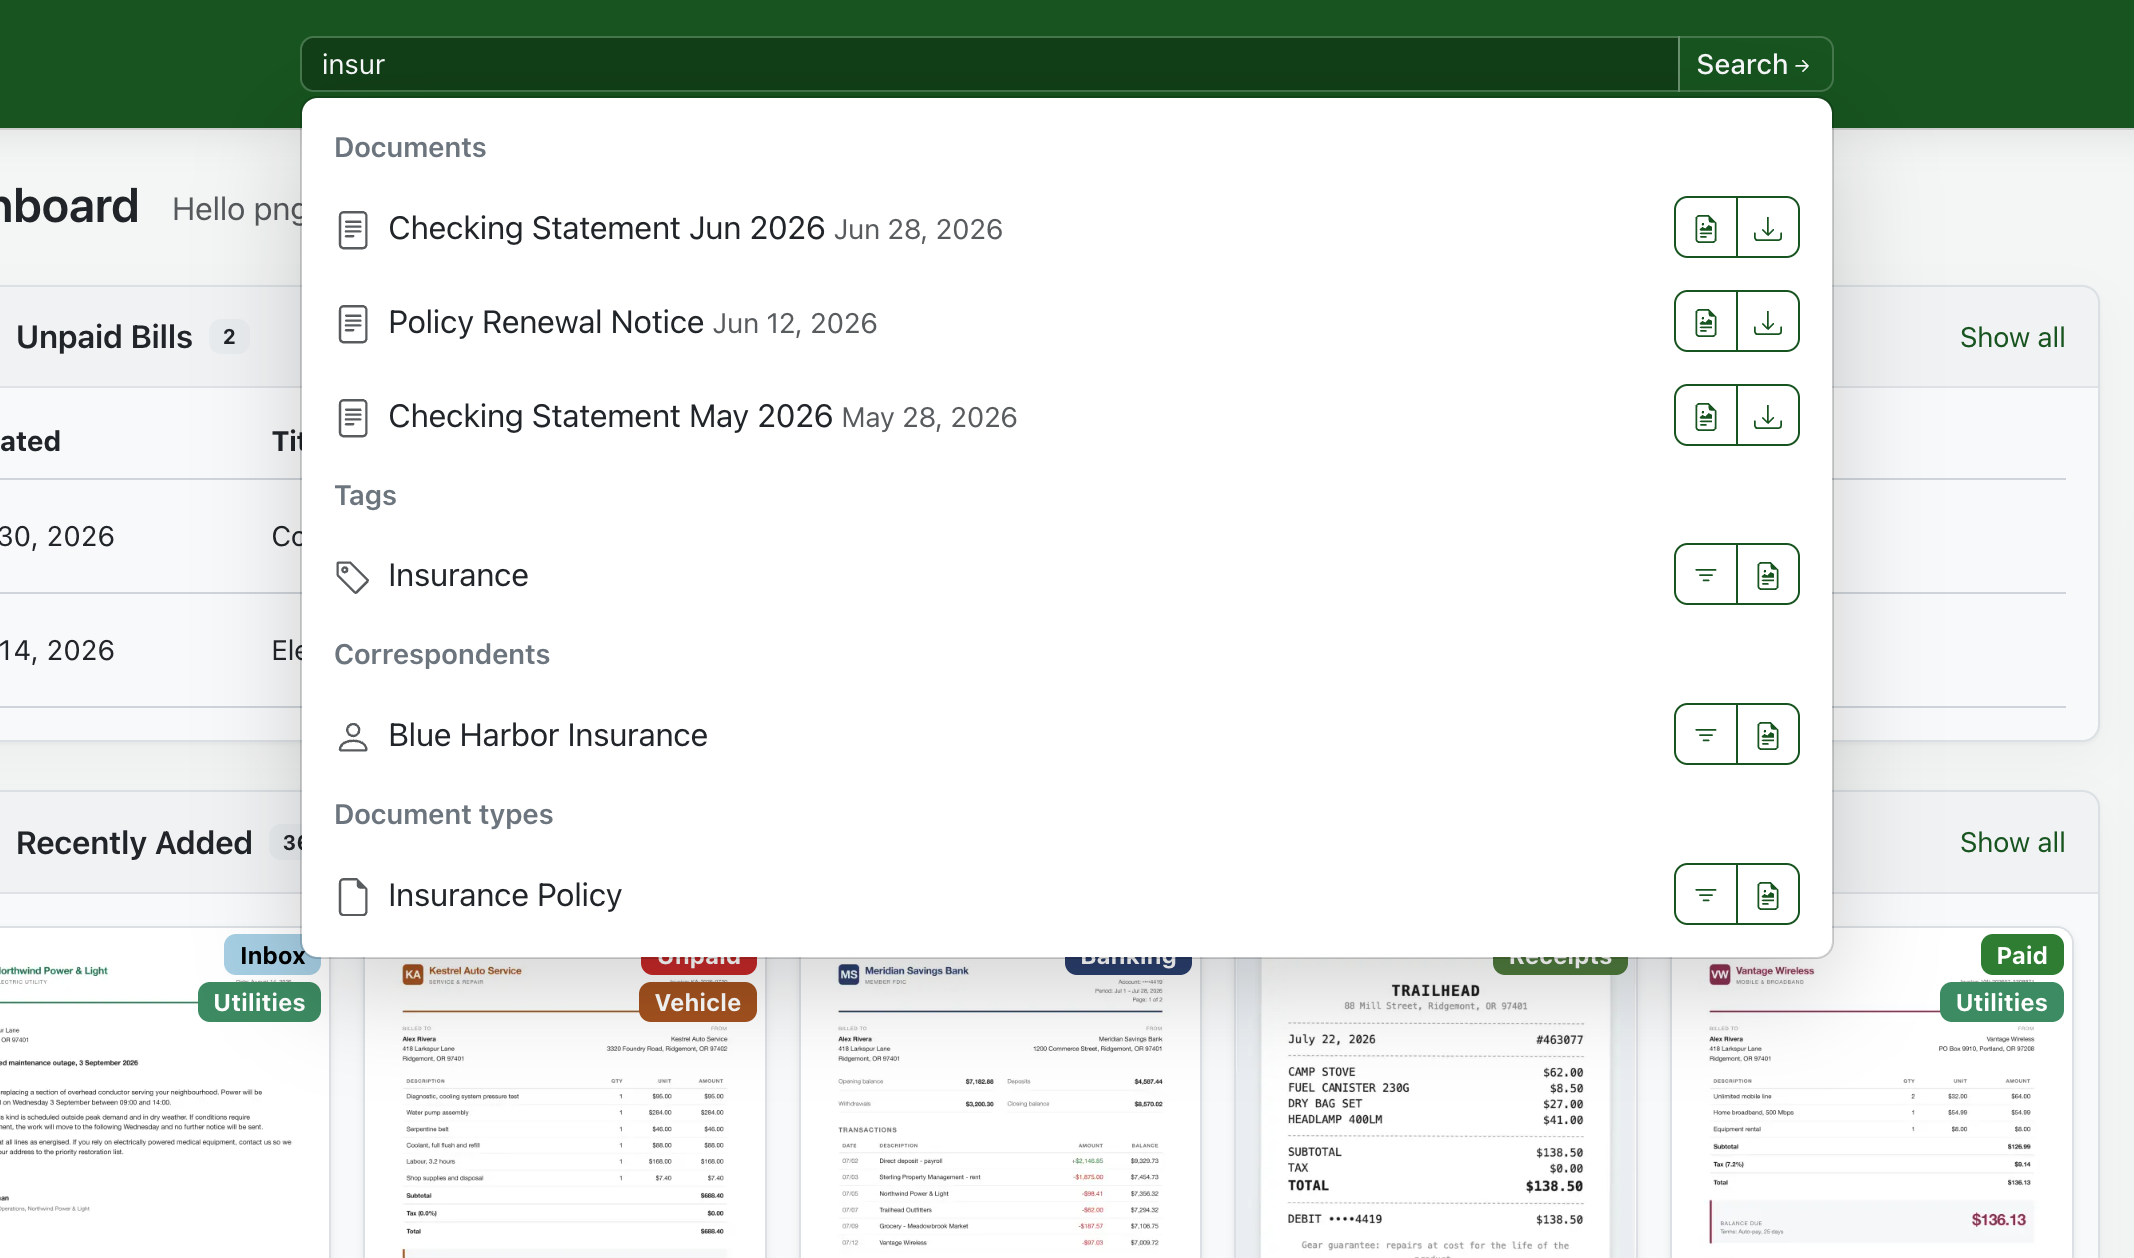
搜索是这套系统真正的入口,官方文档里的搜索体验长这样——输入几个字母,文档、标签、通讯录、文档类型会分组返回:
最小可用配置
"能跑"和"好用"之间,就差下面这几步。
1)先定一套归档命名规则,这是长期受益最大的一项:
PAPERLESS_FILENAME_FORMAT={{ created_year }}/{{ correspondent }}/{{ title }}
PAPERLESS_FILENAME_FORMAT_REMOVE_NONE=true
意思是:media/documents/2026/中国人保/车辆保险单.pdf。好处是——即使哪天 Paperless 挂了,你直接进 media/ 目录用系统自带的文件管理器也能找。这套系统最重要的设计就是"数据不锁死在应用里",别用默认的内部 ID 命名把这个优势浪费掉。
2)配好中文 OCR(前面已给,这里强调一次配对关系):
PAPERLESS_OCR_LANGUAGE=chi_sim
PAPERLESS_OCR_LANGUAGES=chi-sim
如果你的单据是中英混排(发票这种很常见),可以用 eng+chi_sim,两种语言同时识别,代价是慢一点。
3)把"收件箱"接到你顺手的地方。三种常见做法:
- 扫描仪直接扫进 SMB/NFS 共享,再把共享挂进
consume/(记得同时改PAPERLESS_CONSUMER_POLLING_INTERVAL,网络盘上事件通知不可靠) - 邮箱自动收:设置 → Mail → 新建 Mail Rule,填 IMAP 服务器和账号,指定"只处理来自某发件人/主题含发票的邮件"。它会按
PAPERLESS_EMAIL_TASK_CRON的频率(默认约 10 分钟一次)去捞。QQ 邮箱、163 需要单独申请"IMAP 授权码",不是登录密码 - 手机扫描 App 导出后上传:最土但最省事,界面上的上传按钮支持一次拖一堆
4)建标签体系,先少后多。经验是:标签只用来标"状态"(待报销/已归档/待付款),分类交给"文档类型"和"通讯录",这样后续的自动匹配和筛选会好用很多。
5)把权限理顺。如果你打算给同事用,第一步是创建一个日常普通账号,别天天用超管登录——超管能改全局配置、能删任何东西。文档级权限和全局权限在设置里是分开的两套,配工作流动作时也能顺手把"这批文档谁能看"一起定下来。
补一句正事:这套系统一旦上线,就等于把一堆纸质资料数字化集中到了一个地方。含客户个人信息(姓名、手机号)的扫描件慎入,或者至少单独建一批标签 + 只给特定用户权限,别和普通票据混在一起。
告警 / 通知配置
Paperless-ngx 跟第 1 期 Uptime Kuma、第 9 期 changedetection.io 不一样:它本身不是监控工具,所以这里的"告警"是两层意思——文档进来了要不要通知我,以及它自己挂了谁告诉我。
1)文档导入后发通知 → 接第 13 期的 ntfy
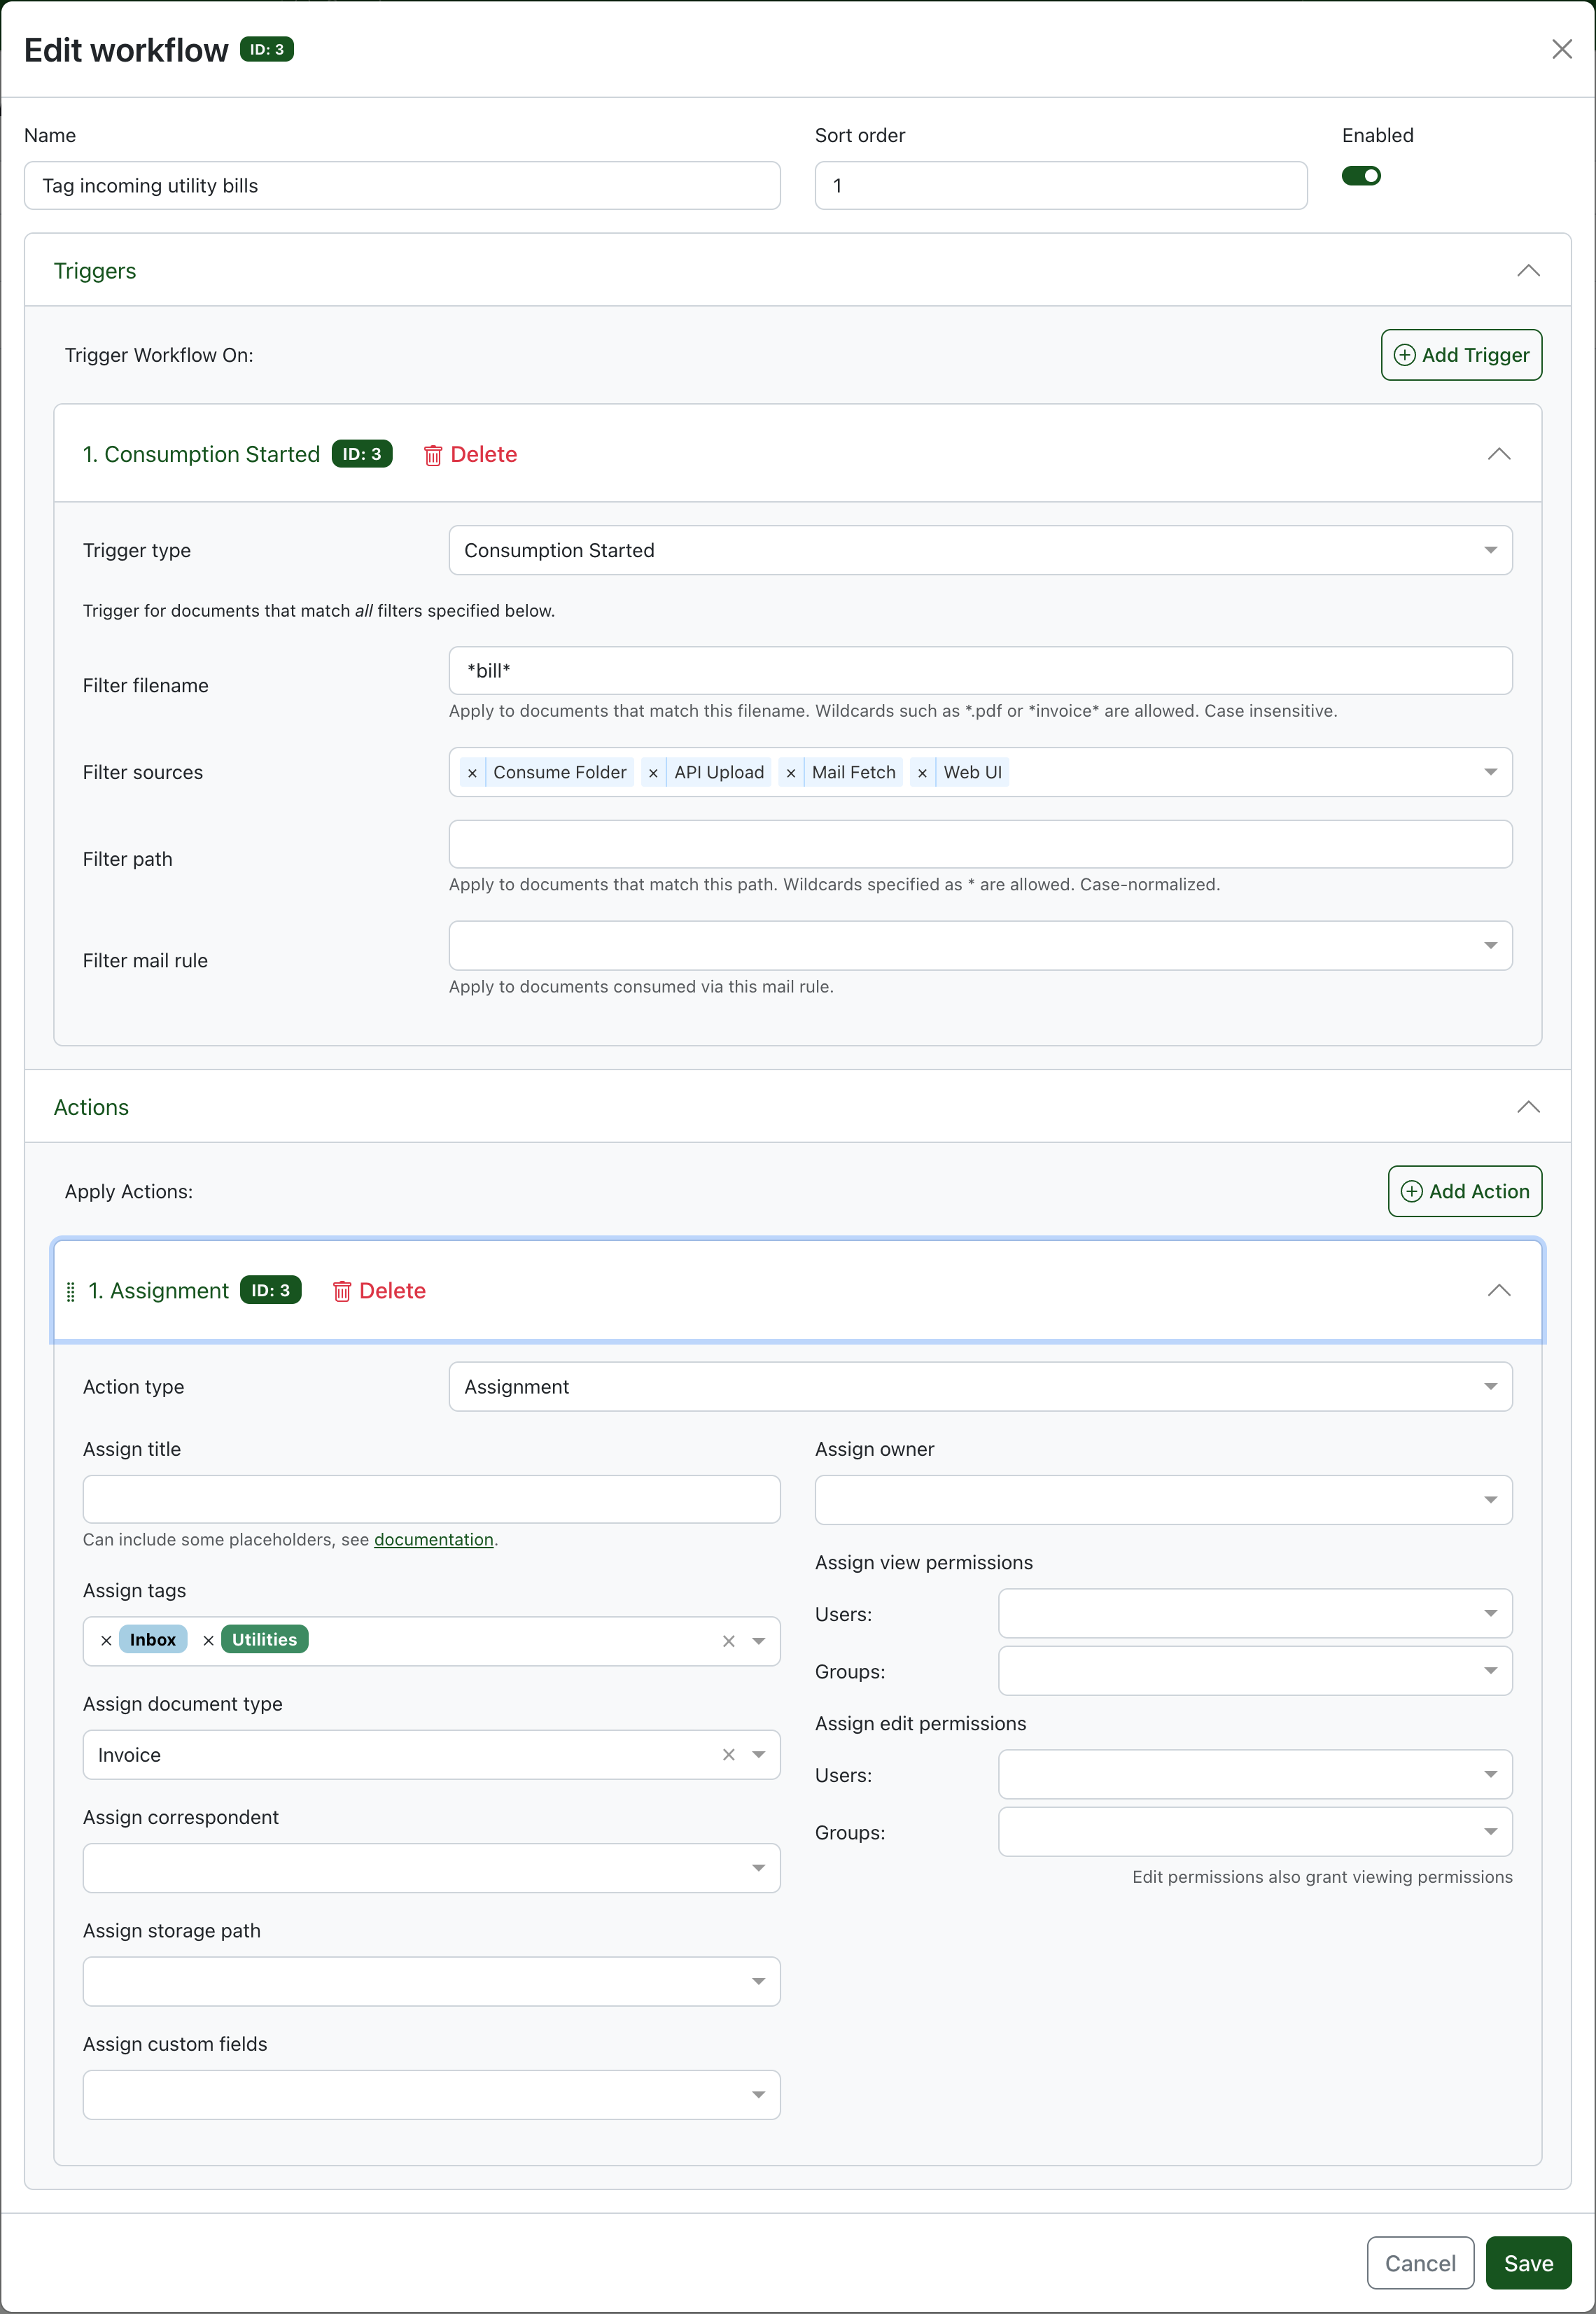
这是 Paperless 最漂亮的一个设计:工作流(Workflow) = 触发器 + 动作。触发器可以是"消费开始/文档更新/定时",动作可以是"打标签/设权限/改标题/发 Webhook"。
配法:设置 → Workflows → 新建:
- 触发器:
Consumption Started,过滤文件名*.pdf(支持通配符) - 动作 1:
Assignment—— 打上Inbox标签 - 动作 2:
Webhook—— 填 ntfy 的地址
Webhook 的目标 URL 就写你第 13 期搭的那条通道:
https://ntfy.你的域名.com/paperless
配一个 Authorization 头带上你的 tk_ 令牌即可(ntfy 支持 Bearer)。这样一份新单据进来的瞬间,手机上就响一下——比"隔三差五去后台看一眼"靠谱得多。
工作流编辑器长这样(官方截图,触发器和动作都是可叠加的):
2)任务失败要能看到
左侧 Tasks 页是它的任务队列,OCR 失败、邮件抓取失败都会在这里留记录并标红。文件太大、格式不认识、密码保护 PDF 都会在这里报出来——新部署完第一周建议每天扫一眼。
想让它主动邮件告警,配好 SMTP 那几项即可:
PAPERLESS_EMAIL_HOST=smtp.example.com
PAPERLESS_EMAIL_PORT=465
PAPERLESS_EMAIL_HOST_USER=你的账号@example.com
PAPERLESS_EMAIL_HOST_PASSWORD=授权码
PAPERLESS_EMAIL_USE_SSL=true
PAPERLESS_EMAIL_FROM=你的账号@example.com
注意这里只管发邮件。收邮件(自动导入发票)是在界面里的 Mail Rule 单独配的,两套配置互不相干——这是新手最容易混的地方。
3)它自己挂了谁告诉你 → Uptime Kuma(第 1 期)
加一个 HTTP 监控,URL https://docs.你的域名.com,关键词可以填 Paperless(登录页标题里就有)。但告警通道别配 ntfy——如果故障刚好出在网络或 ntfy 那条链路上,你会收不到任何消息。这个坑第 13 期专门写过。
再加一个"磁盘快满"的检查:media/ 只会长大不会变小,超出磁盘的那一刻,数据库和 OCR 会一起崩。我自己的做法是用 Uptime Kuma 的 Push 监控 + 一个 cron 脚本上报磁盘占用。
反向代理与 HTTPS
以 Nginx Proxy Manager(第 2 期)为例:
- Hostname/IP:
127.0.0.1:8000(对上 compose 里绑的本机端口) - Scheme:
http - 勾 SSL,申请 Let's Encrypt 证书
- Advanced 里加上传体积限制,不然大 PDF 上传直接 413:
client_max_body_size 200m;
proxy_read_timeout 300s;
Caddy 用户更省事:
docs.你的域名.com {
    reverse_proxy 127.0.0.1:8000
    request_body {
        max_size 200MB
    }
}
三个反代相关的注意点:
PAPERLESS_URL必须和公网地址一字不差(含协议)。它是 CSRF 白名单的来源,写错的表现是"页面能开、登录按钮点了没反应/403"- 登录报 403 的话,看这一条:v3 把登录限流的客户端 IP 判断改了(allauth),反代后面可能出现"认错 IP"导致误判。解法是加:
ini PAPERLESS_TRUSTED_PROXIES=127.0.0.1如果你的代理链不只一跳,还要用PAPERLESS_ALLAUTH_TRUSTED_PROXY_COUNT指明跳数——注意它是"X-Forwarded-For 里的跳数",不是"配置了几个代理 IP" - 反向代理终止 TLS 的场景,如果遇到"重定向到 http",再加一行(值是 JSON 数组字符串,格式不能改):
ini
   PAPERLESS_PROXY_SSL_HEADER=["HTTP_X_FORWARDED_PROTO", "https"]
走 Cloudflare 的话,确认源站能收到X-Forwarded-Proto;有异常先把这个子域名切成 DNS only(灰云)对比一下——我在 ntfy 那期用同样的方法定位过 CDN 层的问题
踩坑清单
- 不设
PAPERLESS_SECRET_KEY直接起不来,而且不能填示例值change-me。生成一次、写进配置文件、别每次重启重新生成,否则登录全掉。 - 中文 OCR 的两个值写反 = 静默失败:装包用
chi-sim(连字符),识别用chi_sim(下划线)。日志里Skipped tesseract-ocr-chi_sim: Package not found!就是写错了。 - 中文 OCR + rootless 二选一。额外语言包是启动时用 apt 装的,非 root 装不了(官方文档明确不支持)。别一边设
user: 1000:1000一边指望它装chi-sim。 PAPERLESS_DBENGINE在 v3 是必填项。只用PAPERLESS_DBHOST的话它不会报错,会安静地退回 SQLite——数据就在容器挂载的data/里,你以为在 Postgres。OCR_MODE=skip/skip_noarchive已删除。v3 把"要不要 OCR"和"要不要生成归档"拆成了OCR_MODE(auto/force/redo/off)和ARCHIVE_FILE_GENERATION(auto/always/never)。老配置留着不生效,只会打一行 warning。升级前如果你依赖 v2 的"永远生成归档",必须显式设always。- 重复文件默认不再拒收了。v3 改成"允许重复、界面上提示"。要恢复旧行为设
PAPERLESS_CONSUMER_DELETE_DUPLICATES=true。 - 搜索索引从 Whoosh 换成了 Tantivy,格式不兼容,首次启动会自动全量重建——索引大的库第一次升级会卡一阵,属正常。另外查询语法变了:
note:xx要写成notes.note:xx,custom_field:xx要写成custom_fields.value:xx;不带前缀的裸词搜索不再匹配笔记和自定义字段。 - 文档加密功能被移除了(v3)。如果你是从古早版本一路升上来的、且用过加密,必须先用
decrypt_documents解密再升级,否则升完打不开。 - 条码引擎只剩 zxing-cpp,
CONSUMER_BARCODE_SCANNER这个变量已删除;如果你的自定义镜像里还装着libzbar0,可以删了。 - 升级 v3 会清空任务历史。Tasks 页升级后是空的,不是丢数据。
postgres:18的卷路径变了:挂/var/lib/postgresql(不是/var/lib/postgresql/data)。照旧文章抄会得到一个"能启动、但每次重启数据都没了"的诡异现象。- 网络盘上的收件箱看不到新文件:
CONSUMER_POLLING_INTERVAL默认0表示用文件系统事件,NFS/SMB 上事件通知经常不工作,必须改成秒数(比如60)。 consume/里的文件会被移走,不是复制。丢进去之后原件会进media/,收件箱里就没了。别把它当成"长期存放目录"。- 老 CPU 上的
trap invalid opcode:NumPy 2.4 起要求 CPU 支持 SSE4.2(grep -o -m1 sse4_2 /proc/cpuinfo没输出就中招),表现是 worker 反复崩溃重启。官方给的出路是PAPERLESS_TRAIN_TASK_CRON=disable(关掉分类器训练,规则匹配不受影响)。 - 上传大文件 413:不是 Paperless 的问题,是反代的
client_max_body_size太小。 - v3 起 pre/post 消费脚本收不到位置参数了,
$1~$8全部改成环境变量(DOCUMENT_ID、DOCUMENT_SOURCE_PATH、DOCUMENT_THUMBNAIL_PATH等)。老脚本会静默拿到空值。 - 别用
:latest。这个项目 minor 版本迭代很快,latest随时可能跨版本跳,破坏性变更全砸你脸上。
备份
Paperless-ngx 的数据分三块,备份策略也不同:
| 位置 | 内容 | 重要性 |
|---|---|---|
media/ |
原始文件 + OCR 归档副本 + 缩略图 | 最高,这份没了就真没了 |
Postgres 卷(或 data/db.sqlite3) |
元数据:标签、通讯录、权限、自定义字段 | 高,丢了要重标一遍 |
data/ |
索引、日志、配置缓存 | 低,可重建 |
官方推荐用内置导出命令,好处是导出的结构在导入时能被完整还原(包括标签、通讯录、自定义字段):
# 全量导出(文档 + 元数据)
docker exec -t paperless document_exporter ../export \
  --use-filename-format --delete

# 恢复(新机器上:先起容器,再执行)
docker exec -t paperless document_importer ../export
顺手的日常备份(media 用 rsync 增量、数据库用 dump):
#!/usr/bin/env bash
set -euo pipefail
BASE=/opt/1panel/docker/compose/paperless
DEST=/backup/paperless/$(date +%F)
mkdir -p "$DEST"

# 1) 数据库逻辑备份(最稳,跨版本也能恢复)
docker exec paperless-db pg_dump -U paperless paperless | gzip > "$DEST/paperless-db.sql.gz"

# 2) 文件增量同步(原件是命根子,且它就是普通文件)
rsync -a --delete "$BASE/media/" "$BASE/export/"

# 3) 顺手备份配置文件
cp "$BASE/docker-compose.yml" "$BASE/docker-compose.env" "$DEST/"
提醒一句:别在容器运行中直接
tar打包 Postgres 的卷,可能拷到一个写了一半的文件,恢复时各种诡异报错。数据库永远优先用pg_dump。另外
PAPERLESS_EMPTY_TRASH_TASK_CRON默认每天 1 点清空废纸篓——"删了还能救"的窗口最多一天,删重要单据前想清楚。
小结
适合谁
- 家里一堆纸质单据、保单、说明书、合同,已经被"找不到"折磨过的人
- 想给公司/店里做一个内部资料库,需要按内容搜、按权限分(4S 店场景下:整备单、上牌资料、保险单、供应商合同各归各类)
- 已经在自托管一套服务(Uptime Kuma + NPM + Immich + ntfy…),愿意再加一个"资料库"补齐最后一块
- 手上有扫描仪,或者愿意用手机扫描 App 的人
不适合谁
- 只有两三份文件的——用第 5 期的 Stirling-PDF 加个网盘文件夹就够了,没必要上这套
- 想要"手机拍一张、五秒后就出现在云端"的那种爽感的——Paperless 的 OCR 是有延迟的,它不是相册
- 想拿它当在线协作编辑器的——它不是 Google Docs
- 完全不想碰配置文件的——这期是所有期里配置项最多的一期,虽然默认值能跑,但域名、密钥、中文 OCR 这几项至少要进一次终端
我这台华为云 ECS 上,前面 13 期攒下来的服务已经有点"各自为政"的意思了:Uptime Kuma 看服务、Immich 管照片、ntfy 送通知、Miniflux 收 RSS。Paperless-ngx 补的是"信息入口"这一环——进来的纸、进来的发票、进来的合同,全都有一个能搜的地方。它可能是这个系列里最不"炫"的一期,但大概率是日子越久越值钱的那一个。
项目地址
- GitHub:https://github.com/paperless-ngx/paperless-ngx
- 官方文档:https://docs.paperless-ngx.com/(配置项全集在
configuration页;v2 升级一定要先读migration-v3) - 演示站:文档首页有 demo 链接,可以先点进去摸一遍再决定要不要装
- Docker 镜像:
ghcr.io/paperless-ngx/paperless-ngx:3.2,Docker Hub 同名项目为paperlessngx/paperless-ngx:3.2(两者 digest 一致)