这是「Docker 好项目」系列的第 24 期。第 1 期 Uptime Kuma 盯的是「服务活着吗」,第 21 期 Kopia 解决的是「盘挂了之后数据还在不在」,但中间一直缺一环:盘本身还撑得住吗。硬盘几乎从不「啪」一声直接坏,它在挂掉之前几周甚至几个月就会把征兆写在 S.M.A.R.T 属性里——重映射扇区数爬升、寻道错误率变差、待定扇区数开始积累——但 Linux 默认没有谁帮你天天盯着这些数字。这期介绍 Scrutiny:把
smartd的 S.M.A.R.T 数据采集下来、存成历史趋势、用 Backblaze 真实故障率数据做阈值判断,最后给你一张 Web 仪表盘,在硬盘开口报错之前先告诉你它快不行了。
痛点开场
先看看你现在对硬盘健康的全部了解:
- 不坏不查:
smartctl -a /dev/sda人人会敲,但没人天天敲。等哪天想起来了,往往是因为机器已经变卡、数据已经读不出来 smartd只发邮件:系统自带的 smartd 能定时采集并告警,但它不区分「致命指标」和「参考指标」——一百多个 SMART 属性里,真正和高故障率相关的就那几个;它也不存历史,你没法回答「05 属性是从上周开始恶化的,还是半年前就这样」- 厂商阈值太迟钝:SMART 的 Threshold 是厂商出厂写死的,不少型号阈值宽到「只够确认这块盘已经坏了」,起不到「预判」的作用
- NAS 自带的健康页只有红绿灯:飞牛、群晖、威联通的存储池页面只告诉你「健康/警告」,不给趋势。你看到的红灯出现时,往往已经进入倒计时
- 数据越攒越多,越不敢赌:照片库、账本、代码仓库全在一块盘上(第 4 期 Immich、第 16 期 Actual Budget、第 10 期 Gitea),赌错一次的代价太大
Scrutiny 的思路很直接:采集这件事交给成熟的 smartctl,判断这件事交给真实世界的故障率数据。它把 Backblaze 公开多年的硬盘故障统计做成阈值模型(warn / failed 两级),某个属性值落在高故障率区间、哪怕厂商阈值还没到,它就先把盘标黄。再配上 InfluxDB 存的历史曲线,你第一次有能力回答「这块盘是在变好还是变坏」。
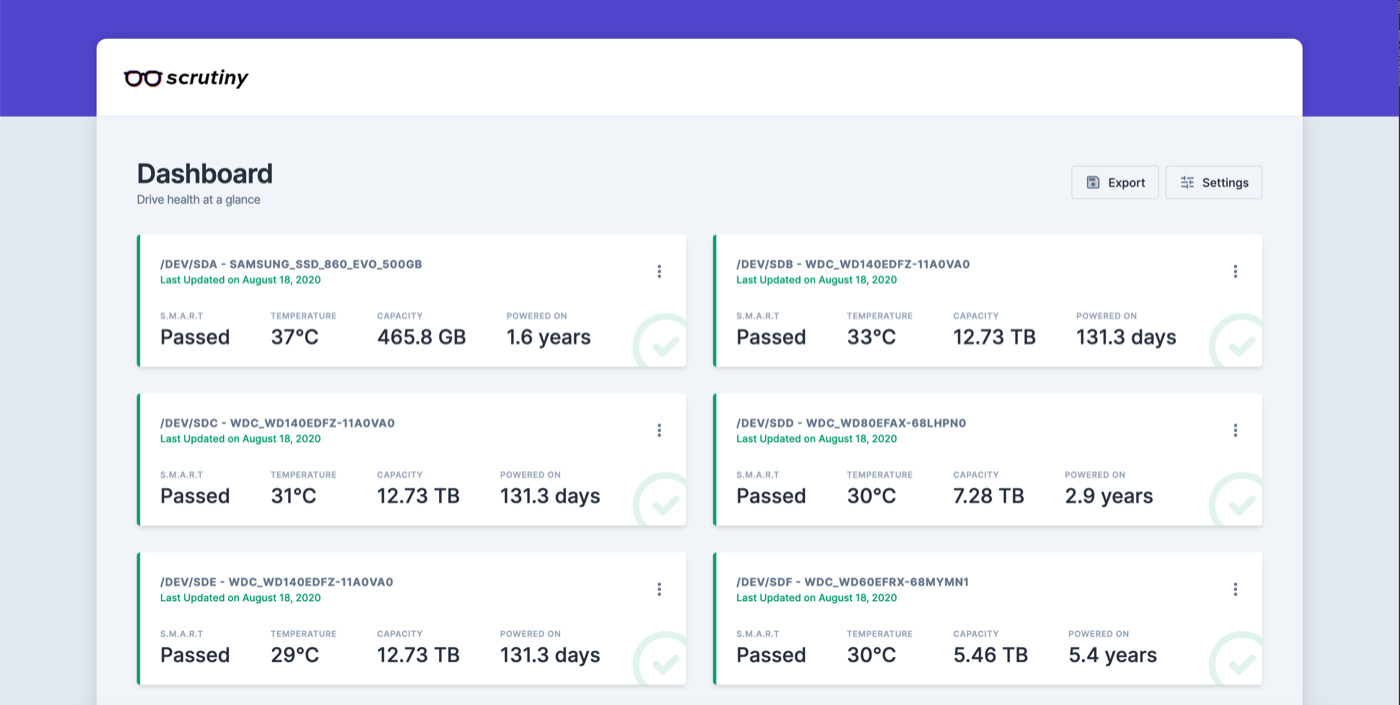
(上图是官方 Dashboard 截图:每块盘一张卡片,S.M.A.R.T 状态、温度、容量、通电时长直接可见,卡片左边一条绿线/黄线就是这块盘的总体判定。)
能力边界
能干什么
- 自动发现全部物理盘:容器一启动就跑
smartctl --scan,ATA / NVMe / SCSI / USB(SAT)自动识别,RAID 阵列卡(MegaRAID / 3ware / HPE cciss 等)加个类型提示也能采 - 历史趋势:SMART 属性 + 温度全部进 InfluxDB,盘详情页有每个属性的历史曲线和 sparkline
- 双阈值判定:厂商 SMART 阈值之外,叠加 Backblaze 真实故障率模型——这是它区别于所有「SMART 查看器」的核心
- Web 仪表盘:Dashboard 只显示关键指标,细节数据点进单盘详情页再看,信息分层做得很好
- 告警:底层用 Shoutrrr,ntfy、Telegram、Discord、Slack、企业微信(
wecom://)、Bark、Gotify、SMTP 邮件、通用 webhook 都支持,还能配自定义脚本(通过环境变量把故障信息传给你的脚本) - 自动降采样:原始数据留 15 天,之后按周/月/年聚合保留 9 周 / 25 个月 / 永久——数据库不会随着年月无限膨胀
- 多机部署(Hub/Spoke):web 只跑一份,collector 镜像往每台物理机各扔一个,数据汇总到同一张仪表盘,靠
host.id分组
不干什么
- 不备份、不救盘。它只负责提前报信。备份是第 21 期 Kopia 的事,两者是上下游关系,互不替代
- 抓不住所有静默损坏。S.M.A.R.T 是盘固件自己汇报的数据,SATA 链路接触不良、线缆抖动导致的传输位翻转,SMART 未必看得到——这类问题还得靠文件系统级校验(btrfs scrub、ZFS scrub、ECC 内存)兜底。Scrutiny 能抓住的是盘本体退化:重映射扇区、待定扇区、寻道错误、通电时间异常增长这些前兆
- 云 VPS 上基本没用。云主机的系统盘是 virtio 虚拟盘,宿主机的 SMART 数据不会透传给虚拟机,
smartctl什么都看不到。这个项目的主场是有物理硬盘的机器:NAS、Homelab、all-in-one、接了 DAS 柜的盒子 - 没有登录、没有多用户。Web 界面完全裸奔(源码里就没有鉴权中间件),公网部署必须自己在反代层加认证,后面细说
- 界面是英文。前端没有 i18n,全英文界面,好信息密度不高、认词就那几个,问题不大但要有预期
- 不做性能测试。测速、压测这类「主动折腾盘」的功能在官方路线图里(Future),当前版本没有
部署前准备
| 项 | 说明 |
|---|---|
| 镜像 | ghcr.io/analogj/scrutiny:v0.9-omnibus。官方只发布到 GitHub 容器仓库 ghcr.io(发布流水线里 registry 写死为 ghcr.io),Docker Hub 上没有官方镜像,国内拉不动先配好加速或代理 |
| tag 规则 | 实测 v0.9-omnibus == v0.9.5-omnibus == v0-omnibus == latest(manifest digest 完全相同),是标准的滚动次版本 tag,会自动跟进 0.9.x 的补丁。镜像分三种:-omnibus(Web + 采集器 + 内置 InfluxDB,单容器全家桶)、-web + -collector(Hub/Spoke 分体部署用) |
| 平台 | omnibus 镜像只有 amd64 / arm64(v0.8.6 起 omnibus 不再编 armv7);分体镜像多一个 armv7。飞牛 NAS 这类 ARM64 设备可以跑 |
| 端口 | 8080/tcp(Web 仪表盘 + API);8086(内置 InfluxDB,容器内部用,不建议映射到宿主机,原因见踩坑清单) |
| 数据卷 | /opt/scrutiny/config(SQLite 数据库 + 两个 yaml 配置)、/opt/scrutiny/influxdb(时序数据)、/run/udev:ro(设备元数据,只读) |
| 内部结构 | Debian trixie + s6-overlay 多进程:Web、InfluxDB 2.2.0、cron(每日采集)、collector-once(启动时先跑一次)四个服务 |
| 权限 | 需要 --cap-add SYS_RAWIO 让 smartctl 能读盘;有 NVMe 盘必须再加 SYS_ADMIN(官方 issue #26 确认)。镜像默认以 root 运行,不支持 PUID/PGID |
| 环境变量 | Web 侧前缀 SCRUTINY_,采集器侧前缀 COLLECTOR_,配置键里的 . 换成 _(如 SCRUTINY_WEB_LISTEN_PORT) |
| 健康检查 | 镜像没有内置 healthcheck,但里面有 curl,可以自己挂一个探 /api/health |
| 资源 | 常驻内存 200MB 上下(InfluxDB 占大头),采集时短暂占用 CPU;数据量很小(每块盘每天一条记录级) |
动手前先在宿主机上确认能看到盘:
smartctl --scan
把这里列出来的每一个设备都记下来,等下全部写进 devices。宿主机上没装 smartmontools 的话先 apt install smartmontools(或 apk add smartmontools)。如果这条命令在宿主机上都扫不出盘,Scrutiny 也救不了——它把检测完全交给 smartctl,自己不做任何魔法。
docker run 一行版
先跑起来看个明白(把 /dev/sda 换成你自己的盘):
docker run -d \
  --name scrutiny \
  --restart unless-stopped \
  -p 8080:8080 \
  -v /opt/scrutiny/config:/opt/scrutiny/config \
  -v /opt/scrutiny/influxdb:/opt/scrutiny/influxdb \
  -v /run/udev:/run/udev:ro \
  --cap-add SYS_RAWIO \
  --device=/dev/sda \
  --device=/dev/sdb \
  -e TZ=Asia/Shanghai \
  ghcr.io/analogj/scrutiny:v0.9-omnibus
浏览器打开 http://服务器IP:8080,等个十几秒(s6 要先拉起 InfluxDB 再拉起 Web),仪表盘就会列出它发现的每一块盘——omnibus 镜像内置的 collector-once 服务会在启动时自动跑第一次采集。
docker-compose 推荐版
正式用建议这份(固定目录 + 手动声明全部盘 + 自挂健康检查):
services:
  scrutiny:
    image: ghcr.io/analogj/scrutiny:v0.9-omnibus
    container_name: scrutiny
    restart: unless-stopped

    ports:
      # 只映射 Web 端口。8086(InfluxDB)不要映射出去
      - "8080:8080"

    volumes:
      # SQLite 数据库 + scrutiny.yaml / collector.yaml 都在这里
      - /opt/scrutiny/config:/opt/scrutiny/config
      # InfluxDB 时序数据(历史趋势图表的数据源)
      - /opt/scrutiny/influxdb:/opt/scrutiny/influxdb
      # udev 设备元数据,采集器靠它拿序列号、型号等信息;只读挂载
      - /run/udev:/run/udev:ro

    cap_add:
      # smartctl 读取 ATA/SATA 盘 SMART 数据的最低权限要求
      - SYS_RAWIO
      # 有 NVMe 盘就必须加(官方 issue #26);纯 SATA 盘环境可以删掉这行
      - SYS_ADMIN

    devices:
      # smartctl --scan 在宿主机上列出的每一块盘都要传进来
      # NVMe 盘传控制器 /dev/nvme0,不要传分区级的 /dev/nvme0n1
      - /dev/sda
      - /dev/sdb
      # - /dev/sdc
      # - /dev/nvme0

    environment:
      # 影响内置 cron 的触发时间,必须设,否则默认 UTC
      TZ: Asia/Shanghai
      # 采集周期,默认每天 0 点(0 0 * * *);改成凌晨 3 点避开整点备份高峰
      COLLECTOR_CRON_SCHEDULE: "0 3 * * *"

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8080/api/health"]
      interval: 60s
      timeout: 10s
      retries: 3
      start_period: 90s
为什么这几处和官方示例不一样:官方 example.omnibus.docker-compose.yml 把 8086:8086 也映射了出来,那是 InfluxDB 的管理端口,而且 omnibus 首次初始化 InfluxDB 用的管理员账号密码是硬编码默认值(admin / password12345,源码 web.influxdb.init_password 默认值)——映射出去等于给公网留了个弱口令后门。Web 端口 8080 就够日常使用了,8086 留在容器网络内部。
配置项逐项解释
compose 之外,Scrutiny 还有两个可选的 YAML 配置文件,都放在挂载的 config 目录里:scrutiny.yaml(Web 侧) 和 collector.yaml(采集器侧)。不创建也能跑,全部走默认值;需要改的时候参考下面。
scrutiny.yaml(Web 侧)常用项
| 配置键 | 默认值 | 说明 |
|---|---|---|
web.listen.port / web.listen.host |
8080 / 0.0.0.0 |
监听端口与地址。host 保持 0.0.0.0 才能在容器里被访问到,收紧访问靠反代和防火墙,不要改这里 |
web.listen.basepath |
'' |
子路径反代时才设,如 /scrutiny。必须同时改采集器的 api.endpoint,见反向代理一节 |
web.database.location |
/opt/scrutiny/config/scrutiny.db |
SQLite 主库路径,记录设备清单、SMART 快照和设置。放在持久化卷里,别动 |
web.influxdb.host / port |
localhost / 8086 |
Hub/Spoke 部署时 host 改成 influxdb(compose 服务名),omnibus 部署不用动 |
web.influxdb.token |
scrutiny-default-admin-token |
Web 连 InfluxDB 用的令牌。omnibus 内部通信用,改不改意义不大;但这就是别把 8086 暴露出去的另一个理由 |
notify.urls |
[] |
告警通道列表,Shoutrrr URL 格式,见告警一节。⚠️ 这是列表,用 env 变量传列表很别扭,建议写在 yaml 文件里而不是环境变量里 |
log.level |
INFO |
排障时改 DEBUG,能看到每次 API 请求和采集上传 |
collector.yaml(采集器侧)常用项
| 配置键 | 默认值 | 说明 |
|---|---|---|
host.id |
'' |
主机标签,Hub/Spoke 部署时用来区分「这批盘是谁的」,仪表盘按它分组。单机 omnibus 不用设 |
devices |
[] |
设备类型修正表。smartctl --scan 识别不准(常见于 RAID 虚拟盘)时,写 device: /dev/bus/0 + type: ['megaraid,14'] 这样的提示;想忽略某块盘写 ignore: true |
allow_listed_devices |
[](采全部) |
白名单,只采集列出来的盘。机器上盘多、但只想盯数据盘时用它,省得仪表盘上全是乱七八糟的 U 盘 |
api.endpoint |
http://localhost:8080 |
采集结果上传地址。omnibus 里容器自己连自己,默认值就是对的;Hub/Spoke 或子路径反代才要改 |
commands.metrics_smartctl_wait |
0 |
每块盘采集之间的等待秒数。老机器上背靠背查盘偶尔会超时,报错就设成 2~5 |
环境变量(优先级高于 yaml 文件)
| 变量 | 默认值 | 说明 |
|---|---|---|
COLLECTOR_CRON_SCHEDULE |
0 0 * * * |
采集周期。只能用环境变量改——cron 是独立进程,不读 collector.yaml,README 里专门强调了这一点 |
COLLECTOR_RUN_STARTUP |
false |
omnibus 不用管(它有自己的 collector-once 服务);单独跑 collector 镜像时设 true 可以启动即采集一次 |
SCRUTINY_WEB_LISTEN_BASEPATH |
'' |
等价于 yaml 里的 web.listen.basepath,子路径反代用 |
仪表盘设置(存在 SQLite 里,改完即时生效,不用重启):点 Settings,注意 Notification Level 默认是 fail——也就是说属性落到「黄色 warn 区」时它不会通知你,只有红了的才发。想尽早收到提醒,把这一项改成 warn。这个默认值是源码里写死的(metrics.notify_level 种子值 = fail),不看源码根本猜不到自己漏了一级告警。
1Panel 面板怎么搞
先泼一盆冷水:1Panel 大概率装在云服务器上,而云服务器是虚拟机——系统盘是 virtio 云盘,宿主机的 SMART 数据不透传,Scrutiny 在这台机器上扫不出任何有价值的东西。所以:
- 云主机 + 1Panel 的组合:不建议装这个。监控云盘靠云厂商的磁盘监控指标就行
- 1Panel 管着家里的物理机 / NAS(或者你在 NAS 上另装了 1Panel):值得装。它的仪表盘比 NAS 自带的红绿灯信息量大得多
自建编排步骤(不同版本商店收录情况不一样,没搜到就直接走容器 → 编排):
# 1. 先在宿主机上把目录建好,避免 Docker 用 root 创建出来权限绕不开
mkdir -p /opt/1panel/apps/scrutiny/scrutiny/config
mkdir -p /opt/1panel/apps/scrutiny/scrutiny/influxdb
然后把上面那份 compose 的三个卷路径改成 /opt/1panel/apps/scrutiny/scrutiny/config 和 /opt/1panel/apps/scrutiny/scrutiny/influxdb,在 容器 → 编排 → 创建编排 里贴进去启动。
两个 1Panel 特有的注意点:
- 映射端口时别勾「外部访问」里的 8086,只放 8080
- 设备透传(
devices:和cap_add:)在 1Panel 的编排编辑器里直接写 YAML 即可,它对 compose 字段是透传的;但如果你用的是「应用商店装应用 + 表单改参数」的模式,表单里没有设备透传字段,必须走编排
首次访问
- 打开
http://服务器IP:8080,会自动跳转到/web路径(源码里根路径就是 302 过去的,这是正常行为不是错误) - 首次启动 s6 要先拉起 InfluxDB、再等 Web 就绪、然后 collector-once 跑第一次采集,整个过程约半分钟到一分钟。如果第一屏空白或报 API 错误,等一下刷新,别急着排障
- Dashboard 会直接列出发现的所有盘:每张卡片有设备名、型号、S.M.A.R.T 判定、温度、容量、通电时长。点进任意一块盘是详情页——左侧是设备档案(序列号、WWN、固件、转速),右侧是 SMART 属性表,每行有 Value / Worst / Threshold / Failure Rate(Backblaze 故障率)和历史曲线
smartctl --scan能看到但仪表盘上没有的盘,九成是忘了写进 compose 的devices里——采集器只处理传进容器的设备,配置文件里写了但容器里没有设备文件也没用- 想立刻再看一次采集(不想等到凌晨 3 点):
docker exec scrutiny /opt/scrutiny/bin/scrutiny-collector-metrics run
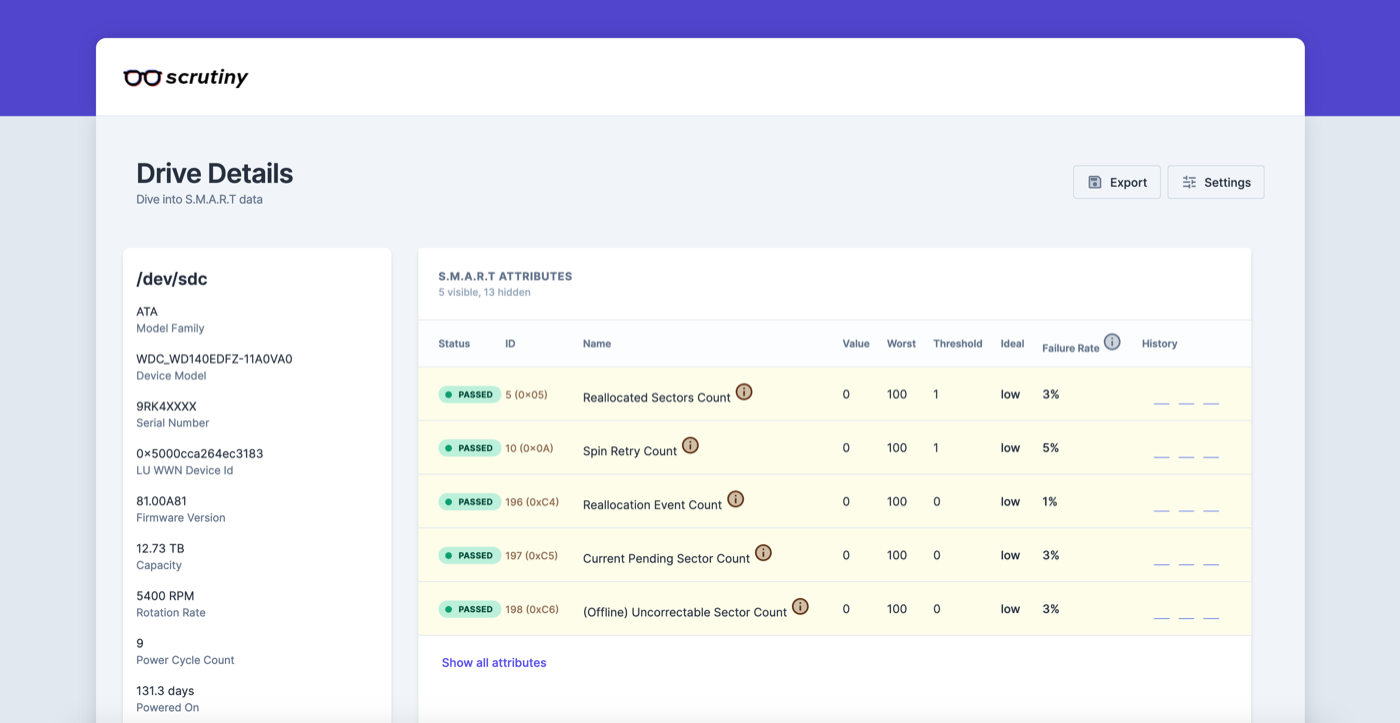
(上图是官方 Drive Details 截图:注意每一行右侧的 Failure Rate 列——3%、5% 这些数字就是 Backblaze 统计出的真实故障率,盘标黄还是标红就看它。)
告警/通知配置
Scrutiny 的告警通道底层是 Shoutrrr 库,一个 URL 一种渠道。在 scrutiny.yaml 里加 notify.urls(建议写在文件里,列表配置走环境变量容易踩坑):
notify:
  urls:
    # 自建的 ntfy(第 13 期):硬盘告警直接推进手机
    - ntfy://ntfy.example.com/disk-alerts
    # iPhone Bark
    - bark://你的devicekey@api.day.app
    # 企业微信机器人
    - wecom://机器人key
    # SMTP 邮件:用户名密码里的特殊字符要 URL 编码
    # - smtp://user%40example.com:password@smtp.example.com:465/?fromaddress=alert@example.com&toaddresses=me@example.com
改完重启容器生效,然后必须做一次真发测试——配置写错(token 拼错、URL 编码漏了)只有测了才知道:
curl -X POST http://localhost:8080/api/health/notify
这个接口会往所有配置的通道发一条测试消息。手机收到了,链路才算通。
三个和告警有关的源码级事实,配之前先知道:
- 默认只报 fail 不报 warn(Settings 里的 Notification Level 默认值是 fail)。想收到黄色预警,去 Settings 改成 warn
- 通知内容会重复发(
metrics.repeat_notifications默认 true):只要故障还在,每次采集都会再发一遍。闹得慌就在 Settings 里关掉,改成「状态变化才发」 - 支持自定义脚本:
notify.urls里可以配脚本路径,Scrutiny 会把故障设备名、序列号、失败类型塞进SCRUTINY_DEVICE_NAME、SCRUTINY_DEVICE_SERIAL、SCRUTINY_FAILURE_TYPE等环境变量传给你的脚本——想接钉钉机器人但 Shoutrrr URL 不趁手时,用脚本兜底
反向代理与 HTTPS
域名方式(推荐):Scrutiny 监听 0.0.0.0:8080,反代到这个地址就行,不需要任何额外配置。1Panel 里建个网站绑定 scrutiny.example.com,反向代理到 http://127.0.0.1:8080,再上 Let's Encrypt 证书。反代片段(/opt/1panel/www/sites/<域名>/proxy/root.conf)保持默认的透传写法即可,它没有要特殊处理的安全头。
但公网暴露前必须解决一个问题:它没有任何登录。源码里没有鉴权中间件,谁拿到地址谁能看全部硬盘信息(序列号、WWN 泄漏不算致命,但不优雅),而且 API 是公开可写的。两个选择:
- 内网/VPN 访问(推荐):只监听内网,或走 Tailscale 这类组网工具访问,根本不暴露公网
- 反代加 Basic Auth:在 1Panel 网站设置里开「密码访问」,或在反代片段里加:
location / {
    auth_basic "Scrutiny";
    auth_basic_user_file /etc/nginx/htpasswd_scrutiny;  # htpasswd -c 生成
    proxy_pass http://127.0.0.1:8080;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
}
子路径方式(没有独立域名,想挂在 example.com/scrutiny/ 下面):这次要动两处,少一处都不行(官方文档明确写了):
# scrutiny.yaml 或环境变量
web:
  listen:
    basepath: '/scrutiny'      # Web 侧:页面和 API 都挂到 /scrutiny 下
# collector.yaml 或环境变量
api:
  endpoint: 'http://localhost:8080/scrutiny'   # 采集器侧:上传地址也要带路径
环境变量写法是 SCRUTINY_WEB_LISTEN_BASEPATH=/scrutiny 和 COLLECTOR_API_ENDPOINT=http://localhost:8080/scrutiny。漏改 collector 那半边的症状是:页面能打开,但仪表盘永远空白——采集数据全被 404 吃掉了。
踩坑清单
1. NVMe 盘扫不出来:缺 SYS_ADMIN
SYS_RAWIO 只够读 SATA/ATA 盘,NVMe 需要 SYS_RAWIO + SYS_ADMIN 两个能力(官方 issue #26)。同时 NVMe 传设备要传控制器 /dev/nvme0 而不是分区设备 /dev/nvme0n1(issue #209)——传错了 smartctl 直接报 open 失败。
2. 不挂 /run/udev:设备检测残缺
采集器从 udev 数据库里拿设备元数据(型号、序列号、WWN)。这个卷忘挂的典型症状是仪表盘上有盘但信息残缺、或者干脆检测不到。Alpine 宿主机默认没有 udev,装 eudev(apk add eudev && setup-udev && udevadm trigger)再挂。
3. 休眠盘会让采集报 exit code 2,还会被唤醒
smartctl 查询休眠中的盘会直接报错(退出码 2),而且查询动作本身会把盘转起来。盘多的机器建议:一是把采集时间调到机器本来就醒着的时间段(别设半夜全休眠时),二是对确实想保持休眠的盘用 allow_listed_devices 排除掉。smartctl 的退出码是位掩码,2 只是「设备打开失败」这一位,文档里有完整的 8 位对照表。
4. 8086 端口不要暴露
内置 InfluxDB 初始化的管理员账号是源码默认值(admin / password12345),访问令牌也是默认字符串。官方示例 compose 映射了 8086,照抄就等于公网上留了个弱口令数据库。本文的 compose 版本已经去掉映射,你也别加回来。
5. 镜像只发 ghcr.io,且别用 nightly
发布流水线里 registry 写死 ghcr.io,Docker Hub 没有官方镜像;nightly-* 是 master 分支每晚自动构建,官方文档明说可能有 bug,生产用 v0.9-omnibus 这种版本 tag。README 原话都在劝你「pin a specific version」。
6. omnibus 没有 armv7
v0.8.6 起 omnibus 镜像只编 amd64 / arm64。老 ARM 盒子(armv7)只能用分体部署(-web / -collector 镜像有 armv7),或者干脆换设备。ARM64 的飞牛/N100 小主机不受影响。
7. 盘一旦判红会一直红着
Scrutiny 的判定参考历史数据:一块盘只要在历史上某次采集中触发过 failed,状态就保留,哪怕后来的阈值规则放宽了、盘也稳定了。这是刻意设计(历史污点不该被洗掉)。确认是误判想重置,用官方文档给的办法:
docker exec -it scrutiny bash
apt update && apt install -y sqlite3
sqlite3 /opt/scrutiny/config/scrutiny.db "UPDATE devices SET device_status = null;"
# 退出后等下次采集,状态会按新数据重新判定
8. RAID 阵列卡不是即插即用
MegaRAID / 3ware / HPE Smart Array 这类控制器下的虚拟盘,smartctl --scan 常常识别不出类型,要在 collector.yaml 里写 type: ['megaraid,14'] 这类提示,还要把 /dev/bus/0 这类设备路径传进容器;个别卡需要直接 --privileged。官方文档 TROUBLESHOOTING_DEVICE_COLLECTOR.md 里按品牌给了完整示例,照抄即可。
9. 升级 0.8 → 0.9 后设备标识变了
v0.9.0 把设备标识从 WWN 换成了 Scrutiny UUID(由 WWN + 型号 + 序列号派生),升级时会自动迁移数据。如果迁移后仪表盘出现「幽灵盘」(旧设备残留),是老版本 fallback WWN 的已知问题,v0.9.2 修了——从 0.8.x 升级直接升到 0.9.2 以上。
10. 采集时间以容器时区为准
COLLECTOR_CRON_SCHEDULE 的 0 3 * * * 是容器本地时间的凌晨 3 点。TZ 没设的话容器跑在 UTC,「凌晨 3 点」实际是北京时间上午 11 点。compose 里那行 TZ: Asia/Shanghai 不是可选项。
备份
Scrutiny 的数据分两半,缺一不可:config/ 里的 SQLite 库(设备清单、SMART 快照、你的设置)和 influxdb/ 里的时序数据(历史趋势曲线)。SQLite 在线复制有 WAL 一致性风险(第 15 期讲过),所以先停再备:
docker stop scrutiny
tar -czf /opt/backup/scrutiny-$(date +%F).tar.gz \
  -C /opt/scrutiny config influxdb
docker start scrutiny
恢复就是把 tar 包解回 /opt/scrutiny/ 原位再启动。数据量很小(单机一年也就几十 MB),往 NAS 或对象存储再抄一份没什么成本。历史趋势丢了大不了从零开始攒,但 SQLite 里的「盘的档案」丢了,故障历史就断了——所以别只备 influxdb 目录。
小结
适合谁
- 有物理硬盘、存了重要数据的机器:NAS、Homelab、all-in-one、DAS 存储柜。数据越值钱,越需要这层「提前半年预警」
- 已经在用 Kopia(第 21 期)做备份的人——备份解决「坏了不丢」,Scrutiny 解决「坏之前先换」,两个一起才是完整的容灾
- 管着多台物理机的:Hub/Spoke 模式一台仪表盘看全部机器的盘
- 用 ntfy(第 13 期)/ Bark / 企业微信的人:
notify.urls一行接上,硬盘告警和你的其他告警进同一个收件箱
不适合谁
- 纯云 VPS:virtio 虚拟盘没有 SMART 可看,装了也是空仪表盘
- 想要「开箱即用、不需要容器特权」的:它必须拿
SYS_RAWIO(NVMe 还要SYS_ADMIN)、必须透传设备文件,这是读 SMART 的物理前提,没有商量余地 - 想要它能挡住一切数据损坏的:线缆接触不良、固件 bug 这类不体现在 SMART 里的静默损坏,它看不见,仍然需要 btrfs/ZFS scrub 和备份兜底
- 在意英文界面的:前端没有中文
一句话总结:smartd 告诉你属性值,Scrutiny 告诉你这块盘还能活多久。把第 1 期 Uptime Kuma(服务在不在)、这期 Scrutiny(盘还能撑多久)、第 21 期 Kopia(坏了怎么救)串起来,自托管的三层保险就齐了。
项目地址
- GitHub:https://github.com/AnalogJ/scrutiny(MIT 协议,8.3k stars)
- 镜像:https://ghcr.io/analogj/scrutiny(tag:
v0.9-omnibus) - 文档:仓库
docs/目录(INSTALL_HUB_SPOKE.md 多机部署、TROUBLESHOOTING_DEVICE_COLLECTOR.md 设备排障、TROUBLESHOOTING_NOTIFICATIONS.md 告警排障)