这是「Docker 好项目」系列的第 30 期。这个系列写到第 30 期,回头看第 1 期写的是 Uptime Kuma——一个点鼠标就能配好的监控面板。第 30 期又回到监控,但换了个路子:Uptime Kuma 是「你在网页上点出来的监控」,Gatus 是「你在 YAML 里写出来的监控」。这一期的理由很简单——服务器多了以后,监控配置本身也该进版本管理;而且 Gatus 有几个 Uptime Kuma 天然做不到的能力:条件式健康判断(不只看 200,还看响应体字段、响应时间、证书剩余天数)、给 README 插可实时更新的 SVG 状态徽章、以及把「网络断了」和「服务挂了」区分开。v5.37.0 于 2026-09-24 发布,Apache-2.0,纯 Go 编译成单二进制,12k stars。
顺便把边界说清楚:它不替代 Uptime Kuma,两者定位不同(第 1 期那篇讲的是一次配置 30 个站点的场景,Gatus 更适合「配置文件即监控定义」)。如果你只有两三个站要盯,Uptime Kuma 更省事;如果你要盯十几个服务、还要把状态码和证书写进文档,往下看。
痛点开场
先说清 Gatus 到底是冲着什么问题来的。
作者在 README 里回答的第一个问题就是:「我有 Prometheus + Alertmanager,为什么还要 Gatus?」答案很直白:指标类监控依赖「有流量」。你的负载均衡器半夜挂了,Prometheus 不会报警——因为没有请求打到后端,错误率曲线是一条平线。等到早上有用户访问、开始报错,你的告警才响。这时候你不是在通知用户,而是在被用户通知。
具体到自托管场景,痛点大概是这几条:
- 指标监控看不到「没人访问」的故障。第 1 期 Uptime Kuma 解决了「从外部主动探测」,但它是纯黑盒的:只看端口通不通、状态码对不对
- 健康判断太浅。「返回 200」不等于「服务正常」。很多服务挂了之后会返回一个 200 的欢迎页或者 502 的 JSON,肉眼看得出来,但黑盒监控看不出来
- 证书过期是个固定门票。Let's Encrypt 三个月一续,续期失败不会立刻炸,往往在你最不方便的时候炸。你要的不是「证书过期了」而是「还有 3 天就过期,赶紧看看」
- 配置点不出版本历史。网页上点出来的监控,谁知道三个月前那个探测条件是谁改的、为什么改
- 状态页要能给别人看。想在自己的 README 或文档里插一个实时状态徽章,或者给同事一个只看不改的状态页
Gatus 的答案是把监控定义彻底变成声明式 YAML:每个端点写 URL + 一组「条件」,条件里可以用 [STATUS]、[RESPONSE_TIME]、[BODY](支持 JSONPath)、[CERTIFICATE_EXPIRATION]、[DOMAIN_EXPIRATION] 这些占位符,条件全过才算健康。配置文件往 Git 里一丢,谁改的、改了什么都清清楚楚;而且容器支持热加载,改完文件不用重启。
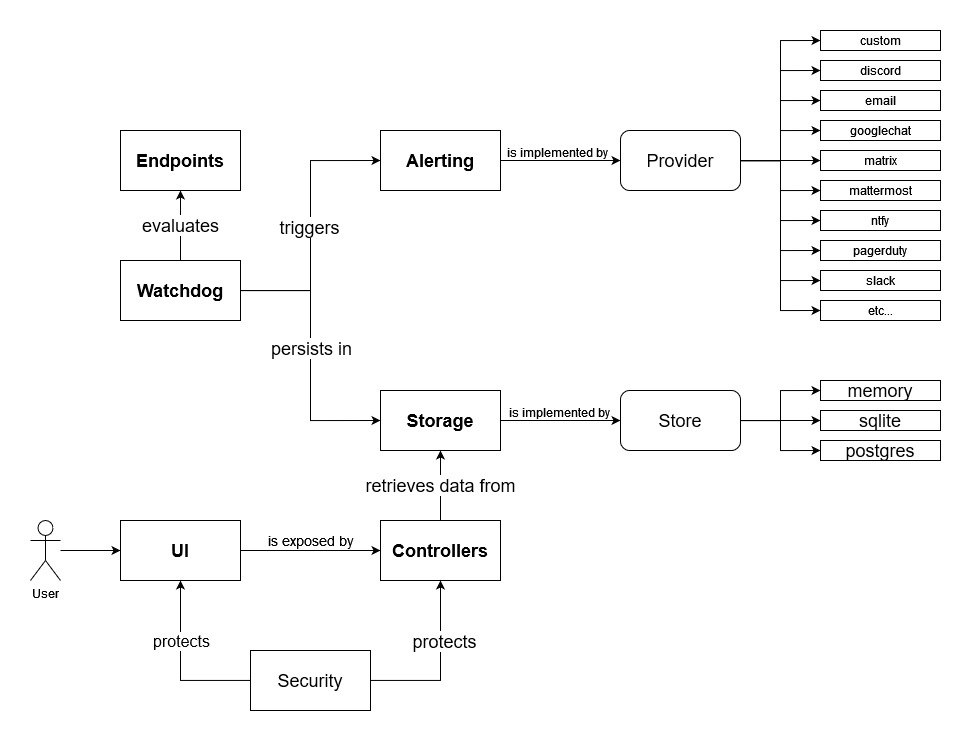
这张是仓库里的架构图:Watchdog 按 interval 主动去请求端点、按你写的 conditions 判定结果,失败的进 Alerting 走各家 Provider(ntfy / Slack / Discord / Telegram / PagerDuty……一共四十来种),结果持久化进 Storage(内存 / SQLite / Postgres),最后通过 Controllers 暴露给 UI。整条链路里唯一需要你写的东西就是 YAML。
能力边界
能干什么(以下基于 v5.37.0 源码与官方 README 逐项核实)
- 多协议主动探测:HTTP/HTTPS、
tcp://、icmp://(ping)、DNS 查询(v5.37.0 起支持 TXT 记录)、SSH、STARTTLS、WebSocket、gRPC、TLS 证书检查、域名到期检查 - 条件式健康判断:这是它跟 Uptime Kuma 最大的差别。举几个真实用法——
[STATUS] == 200:状态码[BODY].status == UP:响应体里 JSONPath 取字段断言(比「状态码是 200」深一层)[BODY] == pat(*<h1>Example Domain</h1>*):响应体里必须出现某段内容(用来防「网关返回 200 但内容是错误页」)[RESPONSE_TIME] < 300:响应时间阈值[CERTIFICATE_EXPIRATION] > 72h:证书还剩多少小时[DOMAIN_EXPIRATION] > 720h:域名还有多久到期has([BODY].errors) == false/len([BODY].data) < 5:has、len、pat、any四个函数- 多级阈值抑制抖动:
failure-threshold: 3表示连续失败 3 次才告警,success-threshold表示连续成功几次才算恢复,send-on-resolved表示恢复时再发一条。「抖一下就发消息」这种噪音能压下去 - 维护窗口:
maintenance里配时间和时长(可以指定只在周几生效),窗口内不告警;还能按端点单独配maintenance-windows - 外部端点(push 模式):
external-endpoints允许别的东西主动把状态推给 Gatus(带上 Bearer token)。适合「Gatus 访问不到的内网机器」反向报活。还带heartbeat:多久没收到推送就自动判定为故障——这个思路和「定时任务没跑」类监控完全吻合 - 测试套件(Suites,ALPHA):多个请求串起来跑,前一个请求的返回值能存进上下文供后面用(
[CONTEXT].token),能测「登录 → 拿数据 → 退出」这种多步流程 - 状态徽章:
/api/v1/endpoints/{key}/uptimes/7d/badge.svg直接出 SVG,可以插进 README、文档、甚至别的网页。还有 Shields.io 格式、健康状态徽章、响应时间徽章 - Prometheus 指标:
metrics: true后在/metrics暴露,能接进现成的 Grafana - 配置热加载:改配置文件不用重启容器(但挂载的是文件本身时可能检测不到,要挂目录,见踩坑)
- 登录保护:HTTP Basic(密码用 bcrypt 哈希)或 OIDC
- 界面:暗色为主,支持
ui:段自定义标题、描述、按钮、Logo、自定义 CSS
不干什么
- 不点鼠标配置。它的哲学就是配置文件即真相。想「打开网页加一条监控」的人会不适应——这是设计选择,不是缺功能
- 不做多用户。没有账号体系、没有角色权限,就是一扇门(Basic / OIDC)+ 一个面板
- 不是告警路由中心。它能往四十来个渠道发消息,但「什么时候发给谁、升级策略」这种复杂编排得靠第 19 期 n8n 或者 Alertmanager 兜
- 不做日志采集、不做 APM、不看服务器 CPU 内存(那是第 27 期 Beszel 的活)
- 不自动发现服务。你得自己把每个端点写进 YAML(好处是不会有意外惊喜)
- 状态页不等于对外公告系统。它有个干净的仪表盘,但没有「发布事件说明、订阅邮件通知」那套事故沟通流程(那是 Uptime Kuma 的强项)
部署前准备
| 项 | 说明 |
|---|---|
| 镜像 | ghcr.io/twin/gatus(官方 README 首选)或 twinproduction/gatus(Docker Hub 同名仓库)。两边是同一份多架构镜像 |
| tag 规则 | 只有 stable、latest 和完整版本号三种。实测 tag 列表 57 个,v5、v5.37 这类滚动 tag 都不存在;:stable 当前与 :v5.37.0 指向同一个 digest(sha256:9dc46f66…),而 :latest 是另一个 digest(2026-10-07 构建)。本期钉 v5.37.0——stable 会跟着最新 release 走,出问题时你连回滚到哪个版本都说不清 |
| 平台 | linux/amd64、linux/arm64、linux/arm/v7(树莓派 32 位也能跑,这点比不少 Go 项目友好) |
| 基础镜像 | scratch——镜像里只有一个 /gatus 二进制 + CA 证书 + 一份示例 config/config.yaml。没有 shell、没有 curl,docker exec 进去什么都干不了,排障只能看日志 |
| 端口 | 容器内 8080(不是 PORT 环境变量决定的,是 web.port 配置项,默认 8080;Dockerfile 里的 ENV PORT=8080 只是 EXPOSE 用的声明,Go 代码里根本没读它——别指望改这个环境变量换端口) |
| 配置路径 | 默认读容器的 config/config.yaml(相对工作目录 /,即 /config/config.yaml),读不到再找 config/config.yml。可用 GATUS_CONFIG_PATH 覆盖,如果指向一个目录,目录下所有 *.yaml / *.yml 会被深度合并(endpoints 数组是追加,alerting.slack.webhook-url 这种标量只能出现在一个文件里) |
| 数据卷 | 镜像没有声明任何 VOLUME,卷要自己挂。要持久化就把 storage.type 设成 sqlite、storage.path 指到挂载点(比如 /data/data.db),再挂 /data |
| 权限 | 容器以 root 运行;ICMP(ping)探测从 v5.31.0 起不需要额外 capabilities,非特权 ping 即可(官方 README 明确写了) |
| 资源 | 极小。Go 单二进制,几十 MB 内存量级,256MB 都富裕 |
| 注意 | 官方文档里那句 docker run -p 8080:8080 --name gatus ghcr.io/twin/gatus:stable 是能跑起来的,因为镜像自带示例配置,监控的是 twin.sh 和 example.org。看着它跑起来了别以为配好了——那是别人的站点 |
docker run 一行版
mkdir -p /opt/gatus/config /opt/gatus/data

cat > /opt/gatus/config/config.yaml <<'EOF'
storage:
  type: sqlite
  path: /data/data.db

endpoints:
  - name: my-blog
    group: web
    url: "https://www.xlee.chat/"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
      - "[CERTIFICATE_EXPIRATION] > 168h"
EOF

docker run -d \
  --name gatus \
  --restart unless-stopped \
  -p 8080:8080 \
  -e GATUS_CONFIG_PATH=/config/config.yaml \
  -e GATUS_LOG_LEVEL=INFO \
  -v /opt/gatus/config:/config \
  -v /opt/gatus/data:/data \
  ghcr.io/twin/gatus:v5.37.0
几个选择的原因:
- 挂目录而不是挂单个文件。
-v /opt/gatus/config:/config是目录挂载,改完config.yaml容器能自动感知并热加载;如果写成-v /opt/gatus/config/config.yaml:/config/config.yaml(bind 单个文件),官方 issue #151 记着这种情况热加载检测不到,你得手动重启 GATUS_CONFIG_PATH=/config/config.yaml显式写出来。默认值是config/config.yaml,在容器里就是/config/config.yaml,效果一样——但显式写能避免「我明明改了文件怎么不生效」这类自我怀疑/data单独一个目录放 SQLite。配置和数据分开挂,备份策略不一样(配置进 Git,数据靠定时备份)- ICMP 探测不用加
--cap-add NET_RAW。v5.31.0 起走非特权 ping 了,老教程里的--cap-add=NET_RAW --cap-add=NET_ICMP现在不需要(加了也不报错,只是多余)
国内拉 GHCR 慢的话可以挂镜像加速前缀,但别改掉镜像名本身,否则以后升级对不上。
docker-compose 推荐版
SQLite 版(单机、日常用,本期推荐):
services:
  gatus:
    image: ghcr.io/twin/gatus:v5.37.0
    container_name: gatus
    restart: unless-stopped
    ports:
      # 只绑回环,外部访问走反向代理;不需要反代就去掉 127.0.0.1: 前缀
      - "127.0.0.1:8080:8080"
    volumes:
      - ./config:/config
      - ./data:/data
    environment:
      GATUS_CONFIG_PATH: /config/config.yaml
      GATUS_LOG_LEVEL: INFO
    healthcheck:
      test: ["CMD", "/gatus", "health", "--url", "http://localhost:8080"]
      interval: 60s
      timeout: 10s
      retries: 3
      start_period: 20s
Postgres 版(多实例共用一个库,或者历史数据想留得比 SQLite 更久):
services:
  gatus:
    image: ghcr.io/twin/gatus:v5.37.0
    container_name: gatus
    restart: unless-stopped
    ports:
      - "127.0.0.1:8080:8080"
    volumes:
      - ./config:/config
    environment:
      GATUS_CONFIG_PATH: /config/config.yaml
    depends_on:
      postgres:
        condition: service_healthy

  postgres:
    image: postgres:17
    container_name: gatus-postgres
    restart: unless-stopped
    environment:
      POSTGRES_DB: gatus
      POSTGRES_USER: gatus
      POSTGRES_PASSWORD: 换成强密码
    volumes:
      - gatus-pgdata:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U gatus -d gatus"]
      interval: 30s
      timeout: 5s
      retries: 5

volumes:
  gatus-pgdata:
Postgres 版的配置里那一行连接串要写对(这是 Gatus 少见的「配置里塞连接串」的地方):
storage:
  type: postgres
  path: "postgres://gatus:换成强密码@postgres:5432/gatus?sslmode=disable"
depends_on 配 service_healthy 是关键——不配的话 Gatus 可能在 Postgres 还没 ready 时就冲上去连,容器直接 panic 退出(它启动阶段连不上库是致命错误,不是降级)。
healthcheck 里那个 /gatus health --url ... 值得解释一下:因为镜像是 scratch、没有 curl 和 wget,官方只能让二进制自己带一个 health 子命令去请求自己的 /health 端点。这是这个项目的镜像形态倒逼出来的用法,不是常规套路。
配置项逐项解释
顶级配置(只列会在生产里真正调的):
| 参数 | 默认值 | 为什么这么写 |
|---|---|---|
endpoints |
必填 | 要监控的端点列表,见下表 |
storage.type |
memory |
三选一:memory / sqlite / postgres。默认内存,重启即归零,历史全没了——所以只要你在乎「昨天的可用率是多少」,就必须改成 sqlite 或 postgres |
storage.path |
"" |
sqlite 时是数据库文件路径(如 /data/data.db),postgres 时是完整连接串(不是路径!)。type: memory 时这个字段必须留空,填了会报错 |
storage.caching |
false |
只在 sqlite / postgres 下生效。写穿缓存,端点特别多(上百)时开,能明显降低仪表盘加载耗时 |
storage.maximum-number-of-results |
100 |
每个端点保留多少条历史结果。SQLite 长期跑想省空间就调小,想看更长的历史曲线就调大 |
storage.maximum-number-of-events |
50 |
每个端点保留多少条事件(状态变化记录) |
metrics |
false |
开了在 /metrics 出 Prometheus 指标。注意 /metrics 是不受 security 保护的(源码里挂在鉴权中间件之前),要收敛就在反代层限制来源 IP |
concurrency |
3 |
同时执行的健康检查数。端点多了(几十个)可以调到 10~20;填 0 表示不限制。调太高会让 [RESPONSE_TIME] 失真(资源竞争导致耗时虚高) |
skip-invalid-config-update |
false |
配置写错时 Gatus 默认直接退出。设 true 会保留旧配置继续跑——但官方自己建议别开,因为下次重启会直接起不来。保持 false,改配置前先本地校验 YAML |
alerting |
{} |
告警渠道配置,见「告警/通知配置」一节 |
security.basic |
{} |
Basic 认证。端点(endpoints[].ui.hide-*)之外,只有 API 受保护,静态资源和首页不受——要拦页面得靠反代 |
maintenance |
{} |
全局维护窗口 |
connectivity.checker.target |
无 | 强烈建议配。写个 1.1.1.1:53,Gatus 会定期确认自己还有外网;一旦自己断网,所有端点检查自动跳过,避免「机房断了,四十个端点一起报警」 |
ui.title / ui.header / ui.dashboard-heading |
见源码默认值 | 页面标题和顶部文案,改成自己认得出来的名字 |
ui.dark-mode |
true |
默认暗色。想给别人看一个浅色状态页就设 false |
ui.buttons |
[] |
顶部加按钮(名称 + 链接),比如「回首页」「看文档」 |
端点级配置(endpoints[]):
| 参数 | 默认值 | 为什么这么写 |
|---|---|---|
name |
必填 | 显示名,也是 URL key 的来源 |
group |
"" |
分组名,仪表盘上按组折叠展示。给「web」「internal」「db」这类分组,端点一多就靠它保持可读 |
url |
必填 | HTTP 填完整 URL;tcp://host:port、icmp://host、DNS 探测填 DNS 服务器地址 |
method |
GET |
需要 POST 才健康的服务(少见)才改 |
conditions |
[] |
条件全部满足才算健康,一条不过就标记为故障。条件写空的话只要请求发出去不出错就算通,几乎是没意义的配置,别偷懒 |
interval |
60s |
检查间隔。作者的用法建议:复杂的健康检查用 5m,用来触发告警的关键检查用 30s。太密没意义还涨噪音 |
headers |
{} |
需要鉴权的端点在这里塞 Authorization,配合下面 ui.hide-url 用 |
body |
"" |
请求体,支持 [RANDOM_STRING_N]、[ENDPOINT_NAME] 这些占位符,做写操作探测时用 |
graphql |
false |
开了会把 body 包成 {"query":"..."},调 GraphQL 接口时省事 |
alerts |
[] |
该端点挂哪些告警渠道。即使配了 default-alert,这里也至少要写 - type: ntfy,不写就是不发 |
client.insecure |
false |
跳过证书校验。自签名证书的内网服务需要它,但能改就用可信任证书,别长期开 |
client.timeout |
10s | 请求超时,见「默认超时」 |
client.network |
ip |
ICMP 走 ip / ip4 / ip6,双栈机器上观察异常时可以显式指定 |
ui.hide-url |
false |
URL 里带 token 时必须打开 |
ui.hide-conditions |
false |
隐藏判定条件,公开状态页时用(不想暴露内部业务字段名) |
ui.hide-errors |
false |
隐藏错误详情,同上 |
ui.badge.response-time |
[50, 200, 300, 500, 750] |
响应时间徽章的配色阈值(毫秒),按自己服务的正常水线调整 |
maintenance-windows |
[] |
单端点维护窗口,比如备份脚本每天凌晨跑的时候别告警 |
extra-labels |
{} |
加进 Prometheus 指标的额外标签,方便 Grafana 里按环境分组 |
always-run / store |
套件专用 | 只在 Suites 里用 |
security.basic 的两个字段:
| 参数 | 值 | 说明 |
|---|---|---|
username |
用户名 | 明文 |
password-bcrypt-base64 |
Base64(bcrypt hash) | 不是明文密码,也不是裸的 bcrypt 串,是「bcrypt 哈希再做一次 base64」。生成方法见下节,这是最容易配错的一项 |
1Panel 面板怎么搞
好消息:1Panel 应用商店收录了 Gatus(对照官方 appstore 仓库核过,官网也有 1panel.pro/apps/gatus 的介绍页)。两条路:
路线 A:应用商店一键装
- 「应用商店」搜
Gatus→ 安装 - 填参数:宿主端口、数据/配置目录
- 装完第一件事是去看它的
config.yaml被放在哪——商店模板里的默认配置监控的是示例站点,你不改成自己的,它就一直是「监控别人的站点」 - 商店装的应用通常是绑定挂载配置目录,改完配置生效一般不用重启(热加载),不生效就重启容器
路线 B:容器 → 编排自建(推荐)
商店模板你不好控制版本 tag 和 security 配置,所以更推荐自己贴 compose:
- 容器 → 编排 → 创建编排:名称填
gatus,把上面 SQLite 版 compose 贴进去,注意把./config、./data换成 1Panel 里的绝对路径(比如/opt/1panel/apps/gatus/config) - 先在宿主上把
config/config.yaml建好再启动,否则容器会读镜像自带的示例配置,成功启动但监控的是 twin.sh——这个坑很隐蔽 - 端口冲突先改宿主端口:8080 被占了就改
ports左边,容器内的 8080 别动(要动得同时改配置里的web.port) - 防火墙放行:1Panel「主机 → 防火墙」放行宿主端口;华为云 ECS 还要单独去云控制台安全组放行——这一步最容易漏。不过更推荐只绑
127.0.0.1,对外走反代,一个端口都不开 - 反向代理(推荐):1Panel「网站 → 反向代理」建一条指向
127.0.0.1:8080,然后在「证书」页签申请 Let's Encrypt - 公开状态页的取舍:如果这个页面要给同事或不认识的人看,两个原则——一是在配置里给敏感端点加
ui.hide-url/ui.hide-conditions/ui.hide-errors(仪表盘要拿到数据才能渲染,加密页面和监控数据本身是矛盾的);二是反代层限制来源 IP,尤其别把/metrics暴露出去
首次访问
浏览器打开 http://服务器IP:8080,没有登录步骤(除非你配了 security)。默认进来就是一个暗色的 Health Dashboard。
第一次打开你会看到几个预设端点——front-end、back-end、monitoring、nas,指向 twin.sh 和 example.org。这说明你的配置没被读到,容器用的是镜像里那份示例 config/config.yaml。检查顺序:
# 1. 容器里的配置路径对不对
docker exec gatus ls -l /config   # scratch 镜像没 shell,这条会失败,改用下面方式

# 2. 直接看日志,启动时会打印实际读到的配置文件路径
docker logs gatus | grep -i "Reading configuration"
# 期望看到:[config.LoadConfiguration] Reading configuration from configFile=/config/config.yaml
那个 docker exec 的注释不是玩笑:scratch 镜像里没有 ls、没有 sh,任何 docker exec gatus <命令> 都会报 executable file not found。排障手段只有 docker logs、docker inspect 和宿主侧的文件操作。
配置读对了之后,仪表盘上就是你自己的端点了。每个端点是一张卡片:名称、分组、URL、健康徽章(Healthy / Unhealthy)、一排细长的历史结果条(绿=成功、红=失败、灰=无数据),鼠标悬停能看到那次检查的时间戳、响应时间和每条条件的判定结果。顶部有搜索框、Filter 和 Sort。「No Group」是没写 group 的端点。
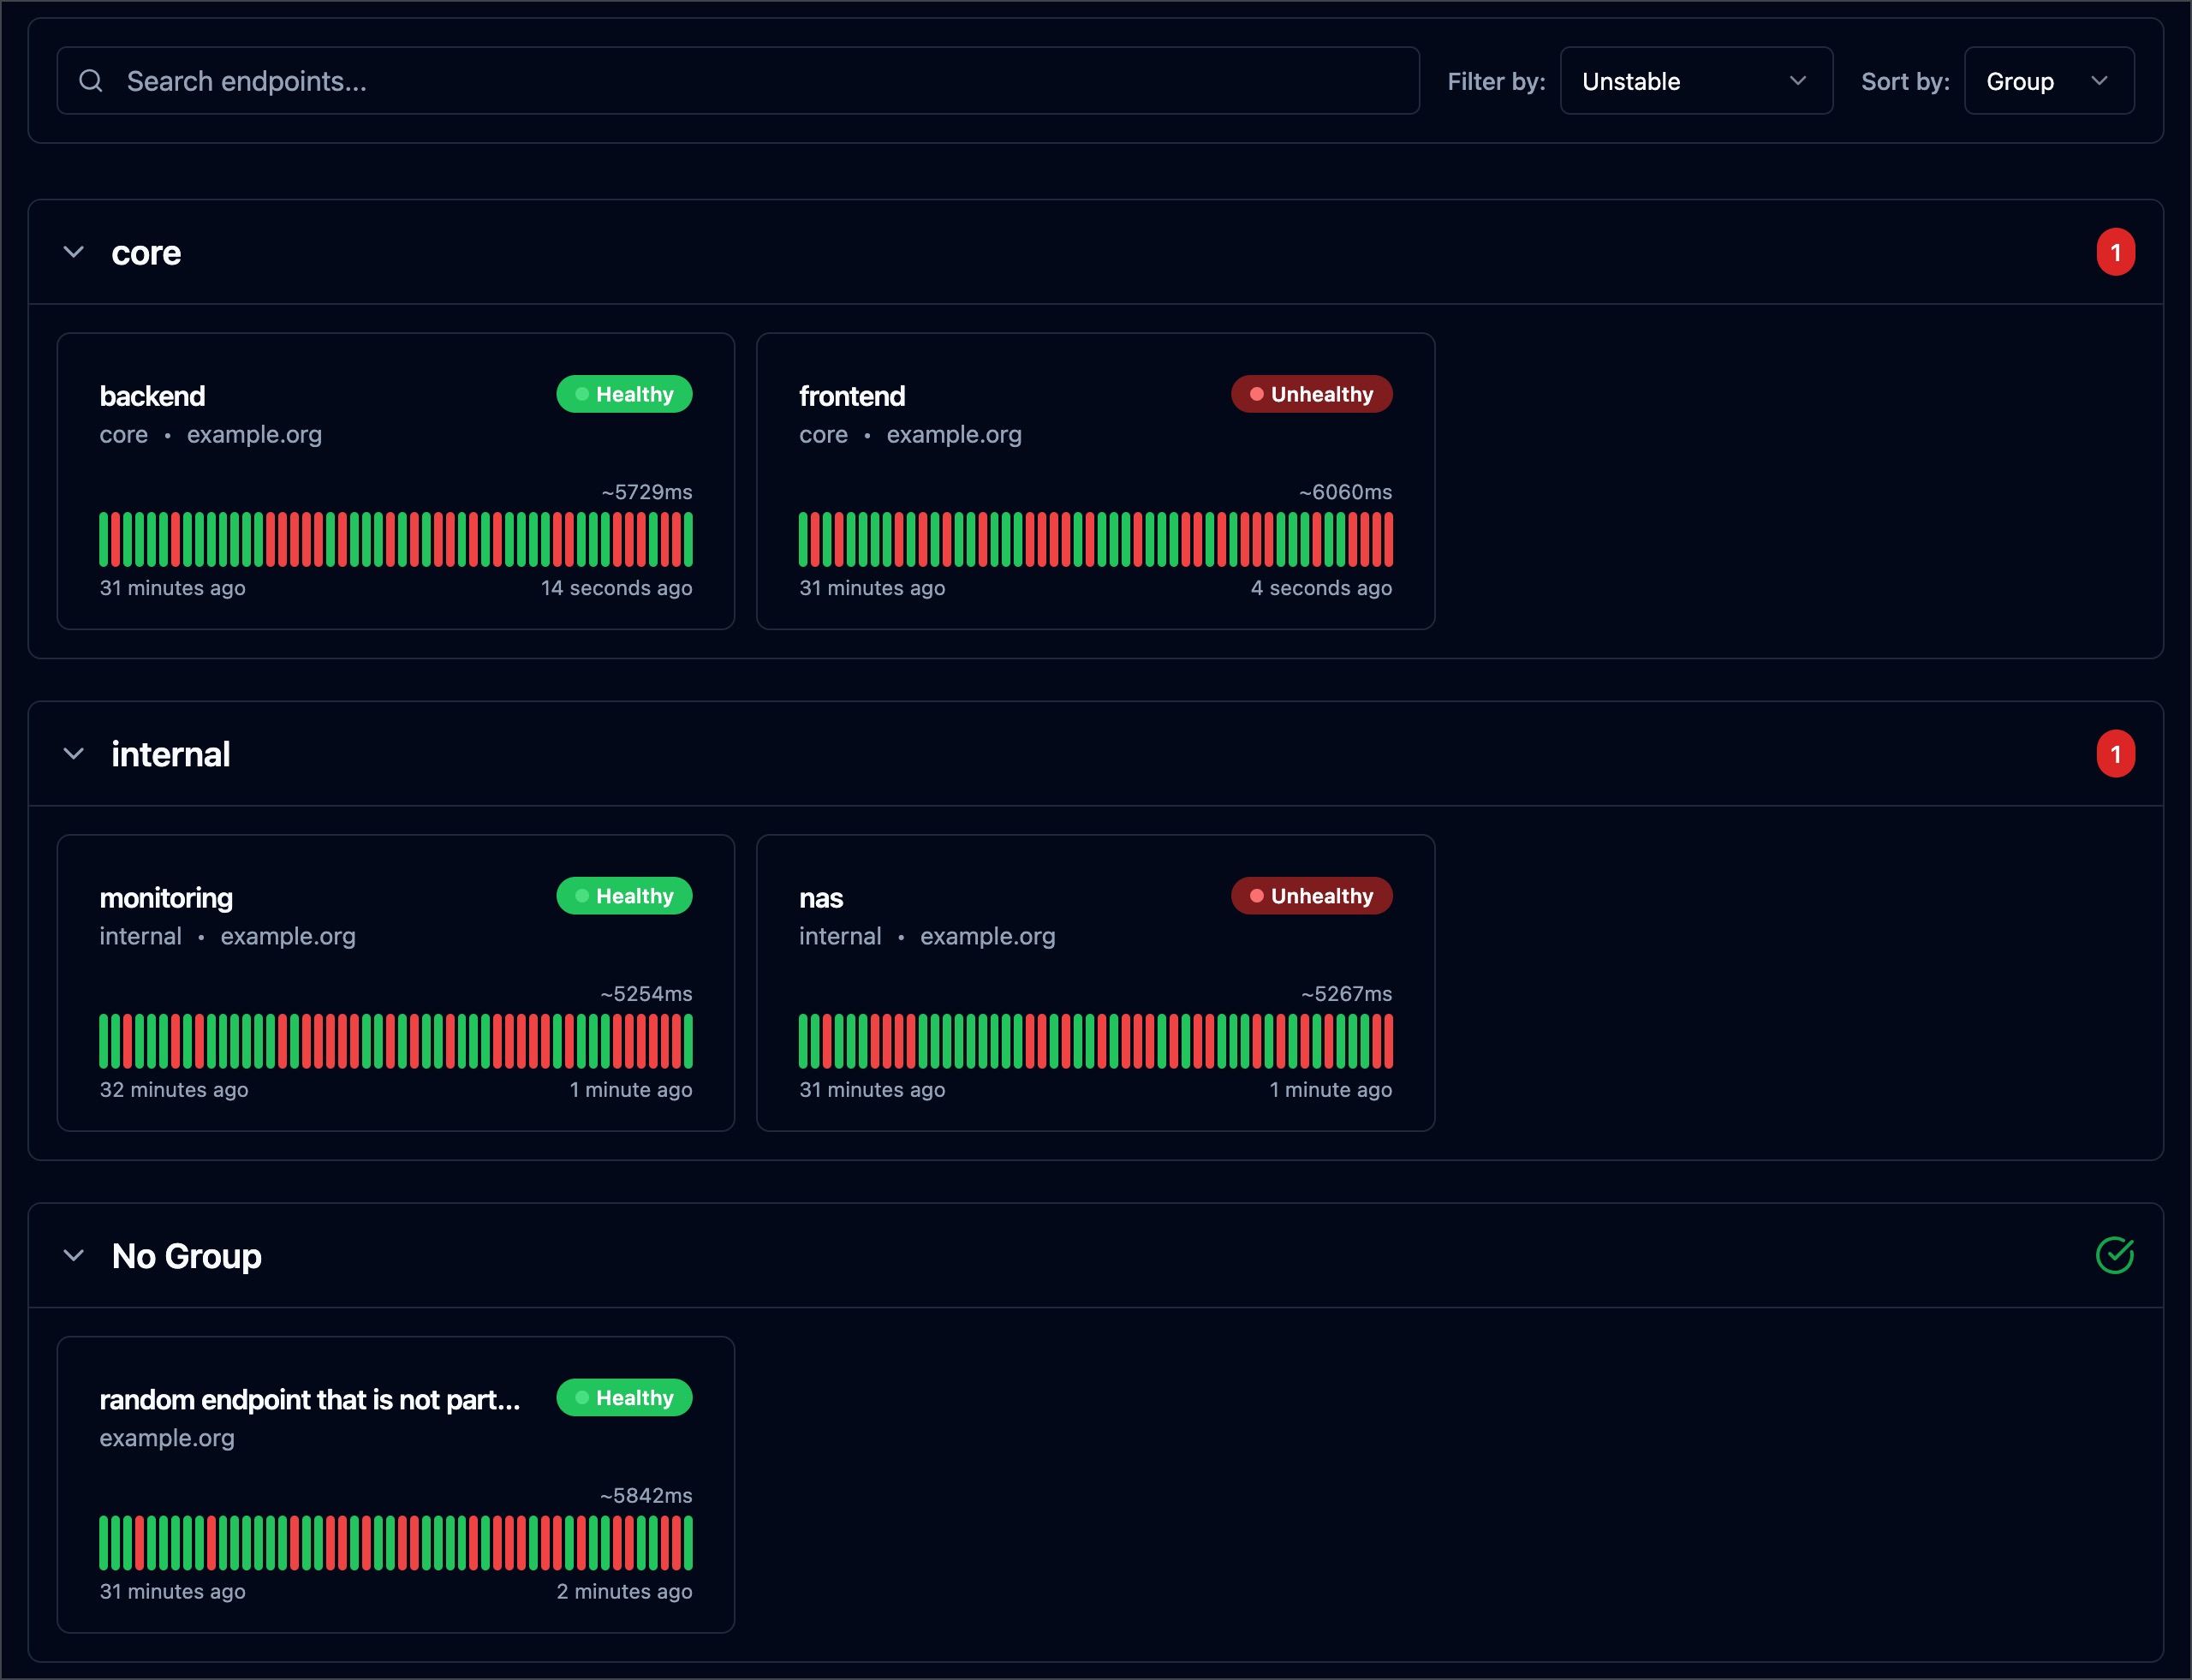
点单个卡片进入端点详情页,那里有更长的历史、响应时间图表,以及这个端点所有可用徽章的地址——想往 README 里插徽章的话,直接从这里复制。
最小可用配置
目标:五分钟内让 Gatus 开始监控你自己的服务,并且历史能存住。
# /opt/gatus/config/config.yaml
storage:
  type: sqlite
  path: /data/data.db
  maximum-number-of-results: 200

connectivity:
  checker:
    target: 1.1.1.1:53
    interval: 60s

ui:
  title: "Status | 我的服务"
  header: "Status"
  dashboard-heading: "服务健康总览"
  dashboard-subheading: "每 5 分钟主动探测一次"
  default-sort-by: group

endpoints:
  # 1. 自己的网站,看状态码 + 证书剩余时间
  - name: blog
    group: web
    url: "https://www.xlee.chat/"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
      - "[RESPONSE_TIME] < 1500"
      - "[CERTIFICATE_EXPIRATION] > 168h"   # 剩一周以上才算健康

  # 2. 有健康检查接口的服务,直接断言接口返回
  - name: halo-api
    group: web
    url: "https://www.xlee.chat/actuator/health"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
      - "[BODY].status == UP"

  # 3. 内网服务,只关心端口通不通
  - name: nas-ssh
    group: internal
    url: "tcp://192.168.31.193:22"
    interval: 1m
    conditions:
      - "[CONNECTED] == true"

  # 4. 域名到期,一天查一次就够
  - name: domain-xlee-chat
    group: infra
    url: "https://www.xlee.chat/"
    interval: 24h
    conditions:
      - "[DOMAIN_EXPIRATION] > 720h"        # 剩 30 天以上
这几条覆盖了日常最实用的四种模式:状态码 + 响应时间(网站)、响应体字段(有 API 的服务)、纯连通性(内网设备)、到期类(域名/证书)。
配完看日志确认没有 not valid 之类的报错,刷新页面就能看到四张卡片。注意 [BODY].status == UP 这类条件写错了不会在启动时报错,只会让那个端点一直显示 Unhealthy——加完端点第一次要去详情页看一眼条件判定,别配完就不管。
告警/通知配置
Gatus 支持四十来种告警渠道。自托管场景里最顺手的两个:ntfy(第 13 期那个,手机上装个 App 就能收)和 通用 webhook(接 n8n、接企业微信机器人、接任何东西)。
推荐写法:default-alert + 端点里只写类型
alerting:
  ntfy:
    topic: "gatus-alerts"
    url: "https://ntfy.example.com"     # 自建 ntfy 的地址;用公共 ntfy.sh 就删掉这行
    token: "tk_你的访问令牌"             # 自建实例开了鉴权才需要
    priority: 3
    click: "https://status.example.com" # 手机点通知跳到状态页
    default-alert:
      enabled: true
      failure-threshold: 3      # 连续失败 3 次才发(5m 间隔 = 15 分钟)
      success-threshold: 2      # 连续成功 2 次才算恢复
      send-on-resolved: true    # 恢复时补一条,不然你不知道什么时候好的
      description: "健康检查失败"
    overrides:                  # 按分组覆盖:内网设备用另一个 topic
      - group: "internal"
        topic: "gatus-internal"
        priority: 2

  # 通用 webhook:接 n8n / 企业微信机器人 / 自己的脚本
  custom:
    url: "https://n8n.example.com/webhook/gatus"
    method: "POST"

endpoints:
  - name: blog
    group: web
    url: "https://www.xlee.chat/"
    interval: 5m
    conditions:
      - "[STATUS] == 200"
    alerts:
      - type: ntfy          # 用了 default-alert,这里仍然必须写 type
三个必须记住的点:
default-alert不会自动生效。它只是「预置参数」,端点alerts里还是要写- type: ntfy。官方 README 对这点有明确警告failure-threshold要跟interval一起算。5m间隔配threshold: 3意味着故障 15 分钟后才叫你;30s间隔配 3 意味着 1 分半。想「快但别抖」就把关键端点的interval压到30s,阈值留 2~3send-on-resolved: true建议都打开。不然告警只有「坏了」没有「好了」,你半夜收到消息之后还得自己爬起来确认
配完怎么验证?把某个端点的 URL 改成一定访问不到的地址(比如 https://127.0.0.1:9/),interval 临时调到 30s,等阈值到点收通知;收到之后改回来,等 send-on-resolved 的恢复消息。别指望「配完就信」——告警没验证过等于没配,这是所有监控系统的通病。
排查用 GATUS_LOG_LEVEL=DEBUG,日志里会打印 configuredProviders=[...] 和 ignoredProviders=[...],能直接看出哪个 Provider 没被识别(配置写错时它会被静默忽略,只是不工作,不报错)。
反向代理与 HTTPS
Gatus 是普通 HTTP 服务,没有 WebSocket 之类的特殊要求,反代配置很标准。以第 2 期 Nginx Proxy Manager 为例:Proxy Host 转发到 127.0.0.1:8080,SSL 页签申请 Let's Encrypt 证书并打开 Force SSL。
原生 nginx 配置:
server {
    listen 443 ssl;
    server_name status.example.com;
    # ssl_certificate / ssl_certificate_key 略

    location / {
        proxy_pass http://127.0.0.1:8080;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }

    # /metrics 不经过 Gatus 的鉴权,在反代层关掉或限 IP
    location = /metrics {
        allow 192.168.31.0/24;
        deny all;
        proxy_pass http://127.0.0.1:8080/metrics;
    }
}
注意 Gatus 的鉴权覆盖范围:security.basic 只保护 /api/v1/... 下的受保护路由,首页 HTML 和静态资源是不拦的。也就是说,光配了 Basic 不等于「整个面板要登录才能看」——想真正做到「打开就要密码」,最省事的办法是在反代层做 Basic 认证(NPM 里叫 Access List,nginx 里用 auth_basic + htpasswd 文件),让它挡在 Gatus 前面。
# 反代层做 Basic 认证(NPM 的 Access List 就是这个原理)
htpasswd -c /etc/nginx/.htpasswd_status admin
另外两个反代侧的注意点:
- 不要开
proxy_buffering off。Gatus 的响应时间探测是服务端行为,跟反代无关,但仪表盘会轮询 API 拉状态,关掉缓冲只是白白增加后端压力 - 想公开状态页但不想被人乱扫:在反代层对
/api/v1/endpoints/statuses限速即可,不要直接把端口开在公网
如果只在家用、不上公网,那就直接 http://192.168.x.x:8080,不必折腾证书。
踩坑清单
- 以为改了
PORT环境变量就能换端口——不行。Go 代码里根本没读PORT,端口只认配置里的web.port(默认 8080)。Dockerfile 里的ENV PORT=8080只配EXPOSE用 - 容器起来了,仪表盘显示的是 twin.sh 和 example.org——你的配置没被读到,容器在用镜像自带的示例
config/config.yaml。用docker logs里的Reading configuration from configFile=...确认实际读的路径 docker exec gatus sh报找不到可执行文件——镜像是scratch,里面只有一个二进制。排障只能看日志、查docker inspect、在宿主侧改文件- 挂了单个配置文件,改完不生效——热加载在 bind mount 单文件时可能检测不到(官方 issue #151)。挂目录而不是挂文件
- 改了配置容器直接退出——
skip-invalid-config-update默认false,配置写错时它选择退出而不是带病运行。改配置前先用yamllint或者随便找个在线 YAML 校验过一遍。别为了「容错」把它设成true,官方自己也建议保持默认 - Basic 认证配了但页面还是能直接打开——
security.basic只保护 API 路由,首页和静态资源不受保护。要「打开就要密码」得在反代层做 Basic password-bcrypt-base64填了密码明文/bcrypt 串就是登不进去——它要的是 base64(bcrypt(password))。用htpasswd -bnBC 9 "" '你的密码' | tr -d ':\n'生成 bcrypt 串,再 base64 一次。官方示例里的成本参数是 10,文档建议 9(Basic 认证每次请求都要验一遍密码,成本越高越慢)storage.type用了sqlite但没写path——启动直接报错sql storage requires a non-empty path。反过来,type: memory时写了path也会报memory storage does not support persistence- Postgres 版的
path写成了文件路径——type: postgres时path要填完整连接串postgres://user:pass@host:5432/db?sslmode=disable,不是目录 - 重启后历史数据全丢——默认
storage.type: memory,不持久化。要留历史就切 sqlite/postgres - ICMP 探测加了
--cap-add NET_RAW还是不通——先看客户端配置;v5.31.0 起非特权 ping 已经够用,加 capabilities 是多余的。真不通时按官方指引看 pro-bing 的 Linux 说明(net.ipv4.ping_group_range之类的内核参数) /metrics被公网扫到——metrics: true时它挂在鉴权中间件之前,不受security保护。要么反代限 IP,要么只绑回环- 告警配了但从来没收到过——两个高频原因:端点
alerts里忘了写- type: ntfy(default-alert不会自动挂载);或者 Provider 名写错被静默忽略(用GATUS_LOG_LEVEL=DEBUG看ignoredProviders) [BODY]条件对非 JSON 响应报错/一直 Unhealthy——[BODY].xxx是 JSONPath,响应体不是 JSON 就用[BODY] == pat(*关键字*)这种模式匹配- 机房断网导致四十个端点一起报警——没配
connectivity.checker。配上target: 1.1.1.1:53,自己断网时自动跳过所有检查 - 端点太多时响应时间数字很奇怪——
concurrency调太高会让[RESPONSE_TIME]因资源竞争虚高。官方建议复杂度高的检查间隔给5m,告警用的简单检查才给30s ipconfig改了interval但没看到变化——interval小于「上一次检查耗时」时,实际执行间隔会被拉长(官方文档专门说了这点)。别给复杂检查配5s- 维护窗口没生效——
maintenance.timezone默认是UTC。想按北京时间每天凌晨 2 点静默,要写timezone: "Asia/Shanghai"和start: "02:00",不然会在北京时间上午 10 点开始静默 - 外部端点(push 模式)收不到数据 401——
Authorization: Bearer <token>里的 token 是配置里external-endpoints[].token的值,且推送路径的 key 是<组名>_<端点名>,空格、/、_、.、#、+、&都会被替换成- - 把
ui:配了一堆结果没看到变化——浏览器 localStorage 里会缓存 UI 偏好,换浏览器或清一下本地存储再看
备份
Gatus 要备的东西不多,就两样:配置文件和存储数据。
配置进 Git(最重要的一条)
cd /opt/gatus
git init
git add config/config.yaml
git commit -m "gatus: 初始监控配置"
这是 Gatus 相对点击式监控最大的价值:谁在什么时候加了哪个端点、为什么把阈值从 3 改成 5,全在 commit 历史里。可以配合一个 systemd timer / cron,每天把改动自动 commit 一次。
SQLite 数据(历史与可用率)
# 建议在容器停止时打包,SQLite 正在写时直接 cp 可能拿到不一致的快照
docker stop gatus
tar czf /backup/gatus-data_$(date +%F).tar.gz -C /opt/gatus/data .
docker start gatus
不停容器的话,用 SQLite 官方的在线备份方式更安全:
# 容器里没有 sqlite3,得在宿主上操作(宿主装了 sqlite3 才行)
sqlite3 /opt/gatus/data/data.db ".backup '/backup/gatus-data_$(date +%F).db'"
Postgres 版:用 pg_dump 就行,容器里就有现成的工具:
docker exec gatus-postgres pg_dump -U gatus -d gatus \
  | gzip > /backup/gatus_$(date +%F).sql.gz
要不要备「数据」这件事,取决于你怎么用 Gatus:如果你只是拿它做即时告警(坏了就发消息),历史数据丢了影响不大——配置在 Git 里,重建容器十分钟的事,data.db 不备也行。如果你想在 Grafana 里看三个月的可用率曲线,那 SQLite/Postgres 的数据就必须认真备。
不管哪种方案,备份文件别只留在同一台机器上——接第 21 期 Kopia 同步到对象存储,才叫备份。
小结
适合谁:手上管着十几个以上服务、习惯把配置写进 Git 的人;需要「不只看 200,还要断言响应体字段」的深度健康检查的人;想在 README 或文档里插实时状态徽章的人;证书/域名到期这类「固定日期炸弹」想统一盯的人;服务器上跑着好几种架构(amd64 + ARM)需要同一份配置的人。已经有 Uptime Kuma 但觉得「点出来的配置没法管」的人,是本期最典型的读者。
不适合谁:就盯两三个站点、偶尔看看的人(Uptime Kuma 点两下更快,别为了 YAML 而 YAML);需要多人协作、分角色权限的团队(没有账号体系);需要复杂告警路由和升级策略的(那是 Alertmanager 的领域);想监控服务器 CPU/内存/磁盘的(那是第 27 期 Beszel);需要对外发布事故公告和邮件订阅的(Uptime Kuma 的状态页更完整)。
跟第 1 期 Uptime Kuma 的关系,一句话讲清:Uptime Kuma 是「一个人肉点出来的监控面板」,Gatus 是「一份能进 Git 的监控配置」。前者上手快、界面友好、状态页功能全;后者判定条件更深、配置可版本化、徽章能嵌进文档、镜像小到几十 MB。真正的最优解是两个都装:Gatus 做深度探测和对外徽章,Uptime Kuma 做那道「机房整体挂了」之外的兜底与状态页——它们监控同一个服务并不冲突,视角不同而已。
项目地址
- GitHub:https://github.com/TwiN/gatus(Apache-2.0,12k stars,最新 release v5.37.0,2026-09-24 发布,约两周一个版本)
- 官方文档:README 本身就是最完整的文档,配置项、条件语法、四十多个告警渠道的接入方式全在里面,
.examples/目录有 SQLite / Postgres / Grafana 三套现成 compose - 镜像:
ghcr.io/twin/gatus:v5.37.0(Docker Hub 同名镜像twinproduction/gatus:v5.37.0) - 1Panel:应用商店已收录,也可走「容器 → 编排」贴 compose 自建(推荐,便于钉版本)
- 配套:第 13 期 ntfy(手机推送)、第 19 期 n8n(告警转微信/钉钉)、第 2 期 Nginx Proxy Manager(反代 + HTTPS)、第 27 期 Beszel(资源层监控,与 Gatus 互补)